트랜스포머(Transformer) 구조 쉽게 이해하기: 현대 AI를 만든 핵심 아키텍처
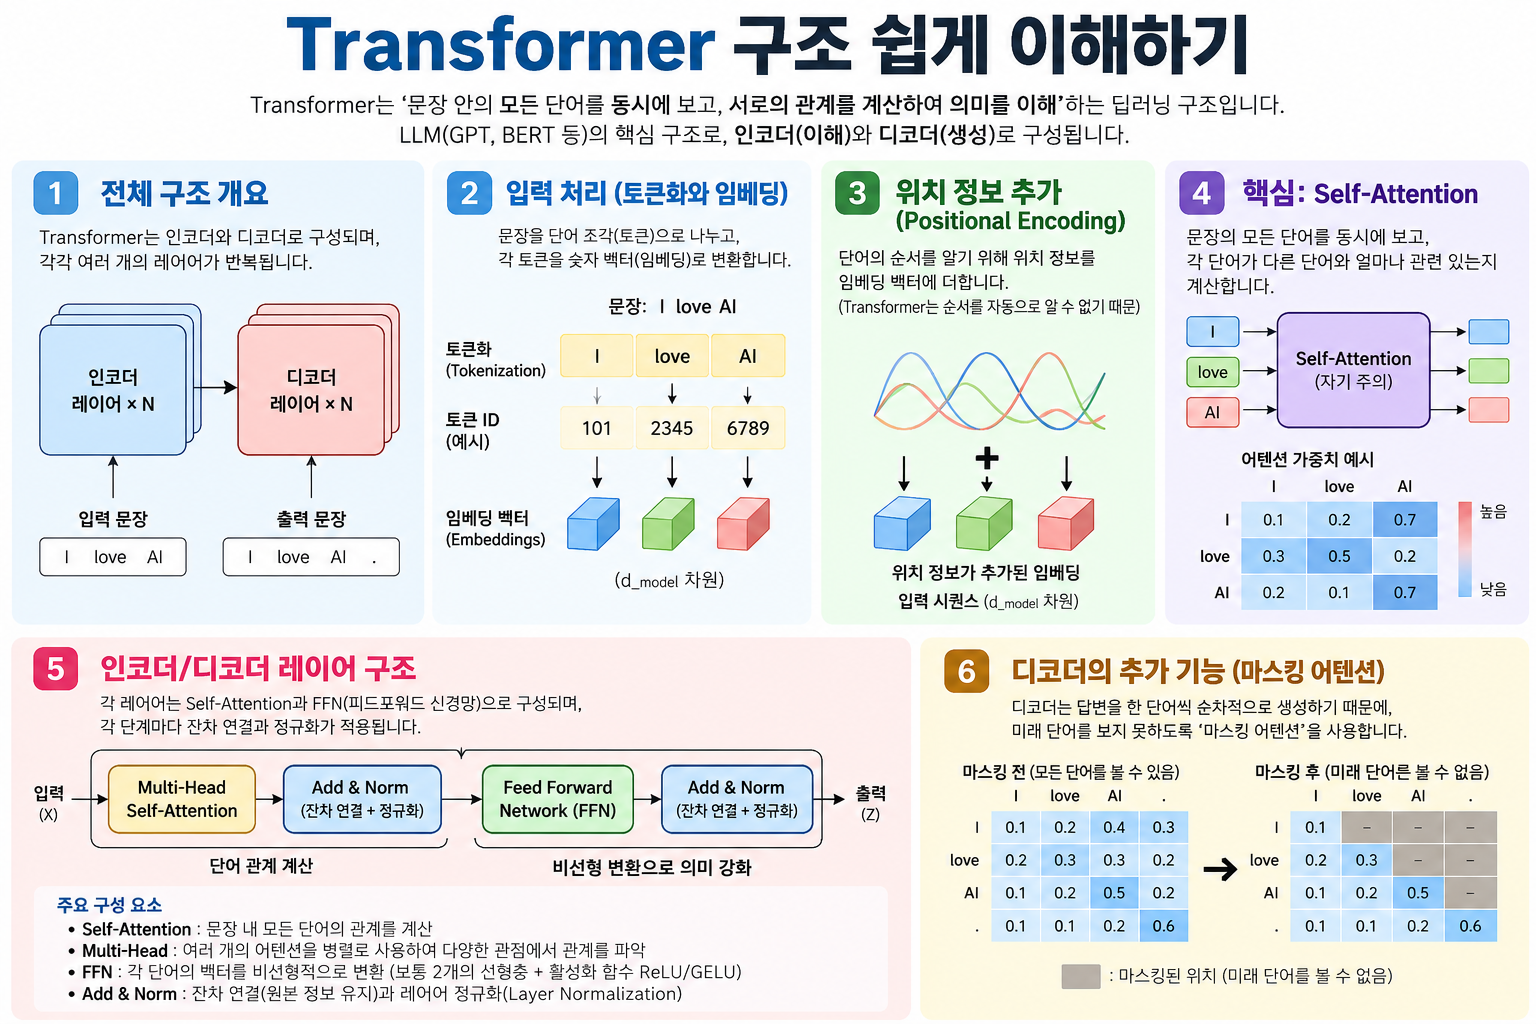
트랜스포머는 문장 전체를 통째로 올려두고 단어 간의 연관성을 한 번에 병렬 연산하는 현대 거대언어모델(LLM)의 핵심 백본 신경망입니다.
과거의 순환 신경망(RNN, LSTM)이 문장을 단어 순서대로 하나씩 순차 처리했던 방식에서 벗어나, 문맥 전체를 한 번에 계산하는 셀프 어텐션(Self-Attention) 구조를 도입하여 자연어 처리 기술의 비약적인 발전을 이끌어냈습니다.
[Flowchart: 트랜스포머의 문장 처리 파이프라인]
[원시 텍스트 입력] ➔ [1. 토큰화 & 임베딩] ➔ [2. 위치 인코딩(Positional Encoding)] ➔ [3. 셀프 어텐션(Self-Attention)] ➔ [4. 피드포워드 신경망(FFN)] ➔ [5. LM Head & Softmax (출력)]
1. 트랜스포머를 지탱하는 4대 핵심 구성 요소
- 위치 인코딩 (Positional Encoding): 단어들을 동시에 병렬로 입력받기 때문에 사라지기 쉬운 어순 정보를 삼각함수(Sin/Cos) 기반 수치 벡터로 임베딩 벡터에 합성합니다.
- 셀프 어텐션 (Self-Attention): 한 문장 안의 모든 단어가 서로에게 미치는 영향력(주목도 가중치)을 직접 계산하여 다의어의 모호성을 해소하고 대명사가 지칭하는 대상을 정밀하게 식별합니다.
- 피드포워드 신경망 (Feed-Forward Network, FFN): 어텐션 블록이 추출한 문맥 관계 정보를 각 토큰 위치별로 독립적인 비선형 변환을 거쳐 모델 내부 파라미터 지식으로 축적합니다.
- 잔차 연결 및 정규화 (Add & Norm): 신경망 레이어가 깊어져도 신호가 소실되거나 왜곡되지 않도록 안정적인 학습 및 추론 흐름을 유지합니다.
2. 셀프 어텐션의 핵심: Q·K·V 메커니즘
셀프 어텐션은 검색 엔진의 질의·응답 구조와 유사한 Q·K·V 연산을 통해 수행됩니다.
- Query (질의): 현재 분석 기준이 되는 대상 단어
- Key (키값): 문맥 내 비교 대상 단어들의 고유 식별 주소
- Value (내용값): 각 단어가 지닌 실제 의미 정보의 벡터
Query와 Key의 내적을 계산하여 상호 유사도(어텐션 스코어)를 구하고, 이를 가중치 삼아 Value 벡터를 가중합함으로써 문맥이 온전히 반영된 새로운 단어 벡터를 도출합니다.
3. 기존 순환 신경망(RNN) vs 트랜스포머 비교
| 비교 항목 |
전통적 시퀀스 모델 (RNN / LSTM) |
트랜스포머 (Transformer) |
| 처리 방식 |
단어를 순서대로 하나씩 처리 (Sequential) |
문장 전체 단어를 일괄 병렬 처리 (Parallel) |
| 연산 속도 |
GPU 병렬 연산 제약으로 학습 속도 한계 |
뛰어난 병렬화로 대규모 고속 연산 가능 |
| 장기 문맥 처리 |
문장이 길어질수록 앞쪽 정보 소실 발생 |
토큰 간 거리에 관계없이 전체 문맥을 균등 참조 |
| 핵심 기법 |
순환 은닉 상태(Hidden State) 누적 |
셀프 어텐션(Self-Attention) 가중합 연산 |
| 모델 확장성 |
파라미터 대형화에 물리적 제약 존재 |
수십억~수천억 파라미터(LLM)로 무한 확장 가능 |
4. 트랜스포머 기반의 3대 모델 계열
- 인코더 전용 모델 (예: BERT): 문맥 전체를 양방향으로 깊이 있게 분석하는 데 특화되어 문서 분류, 문장 유사도 평가, 정보 추출에 적합합니다.
- 디코더 전용 모델 (예: GPT, Llama): 앞서 등장한 단어를 바탕으로 다음 단어를 연속 예측(자기회귀)하는 텍스트 생성 작업에 탁월합니다.
- 인코더-디코더 복합 모델 (예: T5): 입력을 정밀하게 해석한 후 새로운 언어나 형태로 재구성하는 번역 및 장문 요약 과업에 최적화되어 있습니다.
트랜스포머는 단어를 순차적으로 읽던 기존의 틀을 깨고, 단어 간 상호작용을 병렬 행렬 연산으로 처리하는 독창적인 설계를 완성했습니다. 오늘날 모든 거대언어모델의 뛰어난 문맥 이해와 지능은 바로 이 트랜스포머 구조에서 시작됩니다.

댓글목록
등록된 댓글이 없습니다.