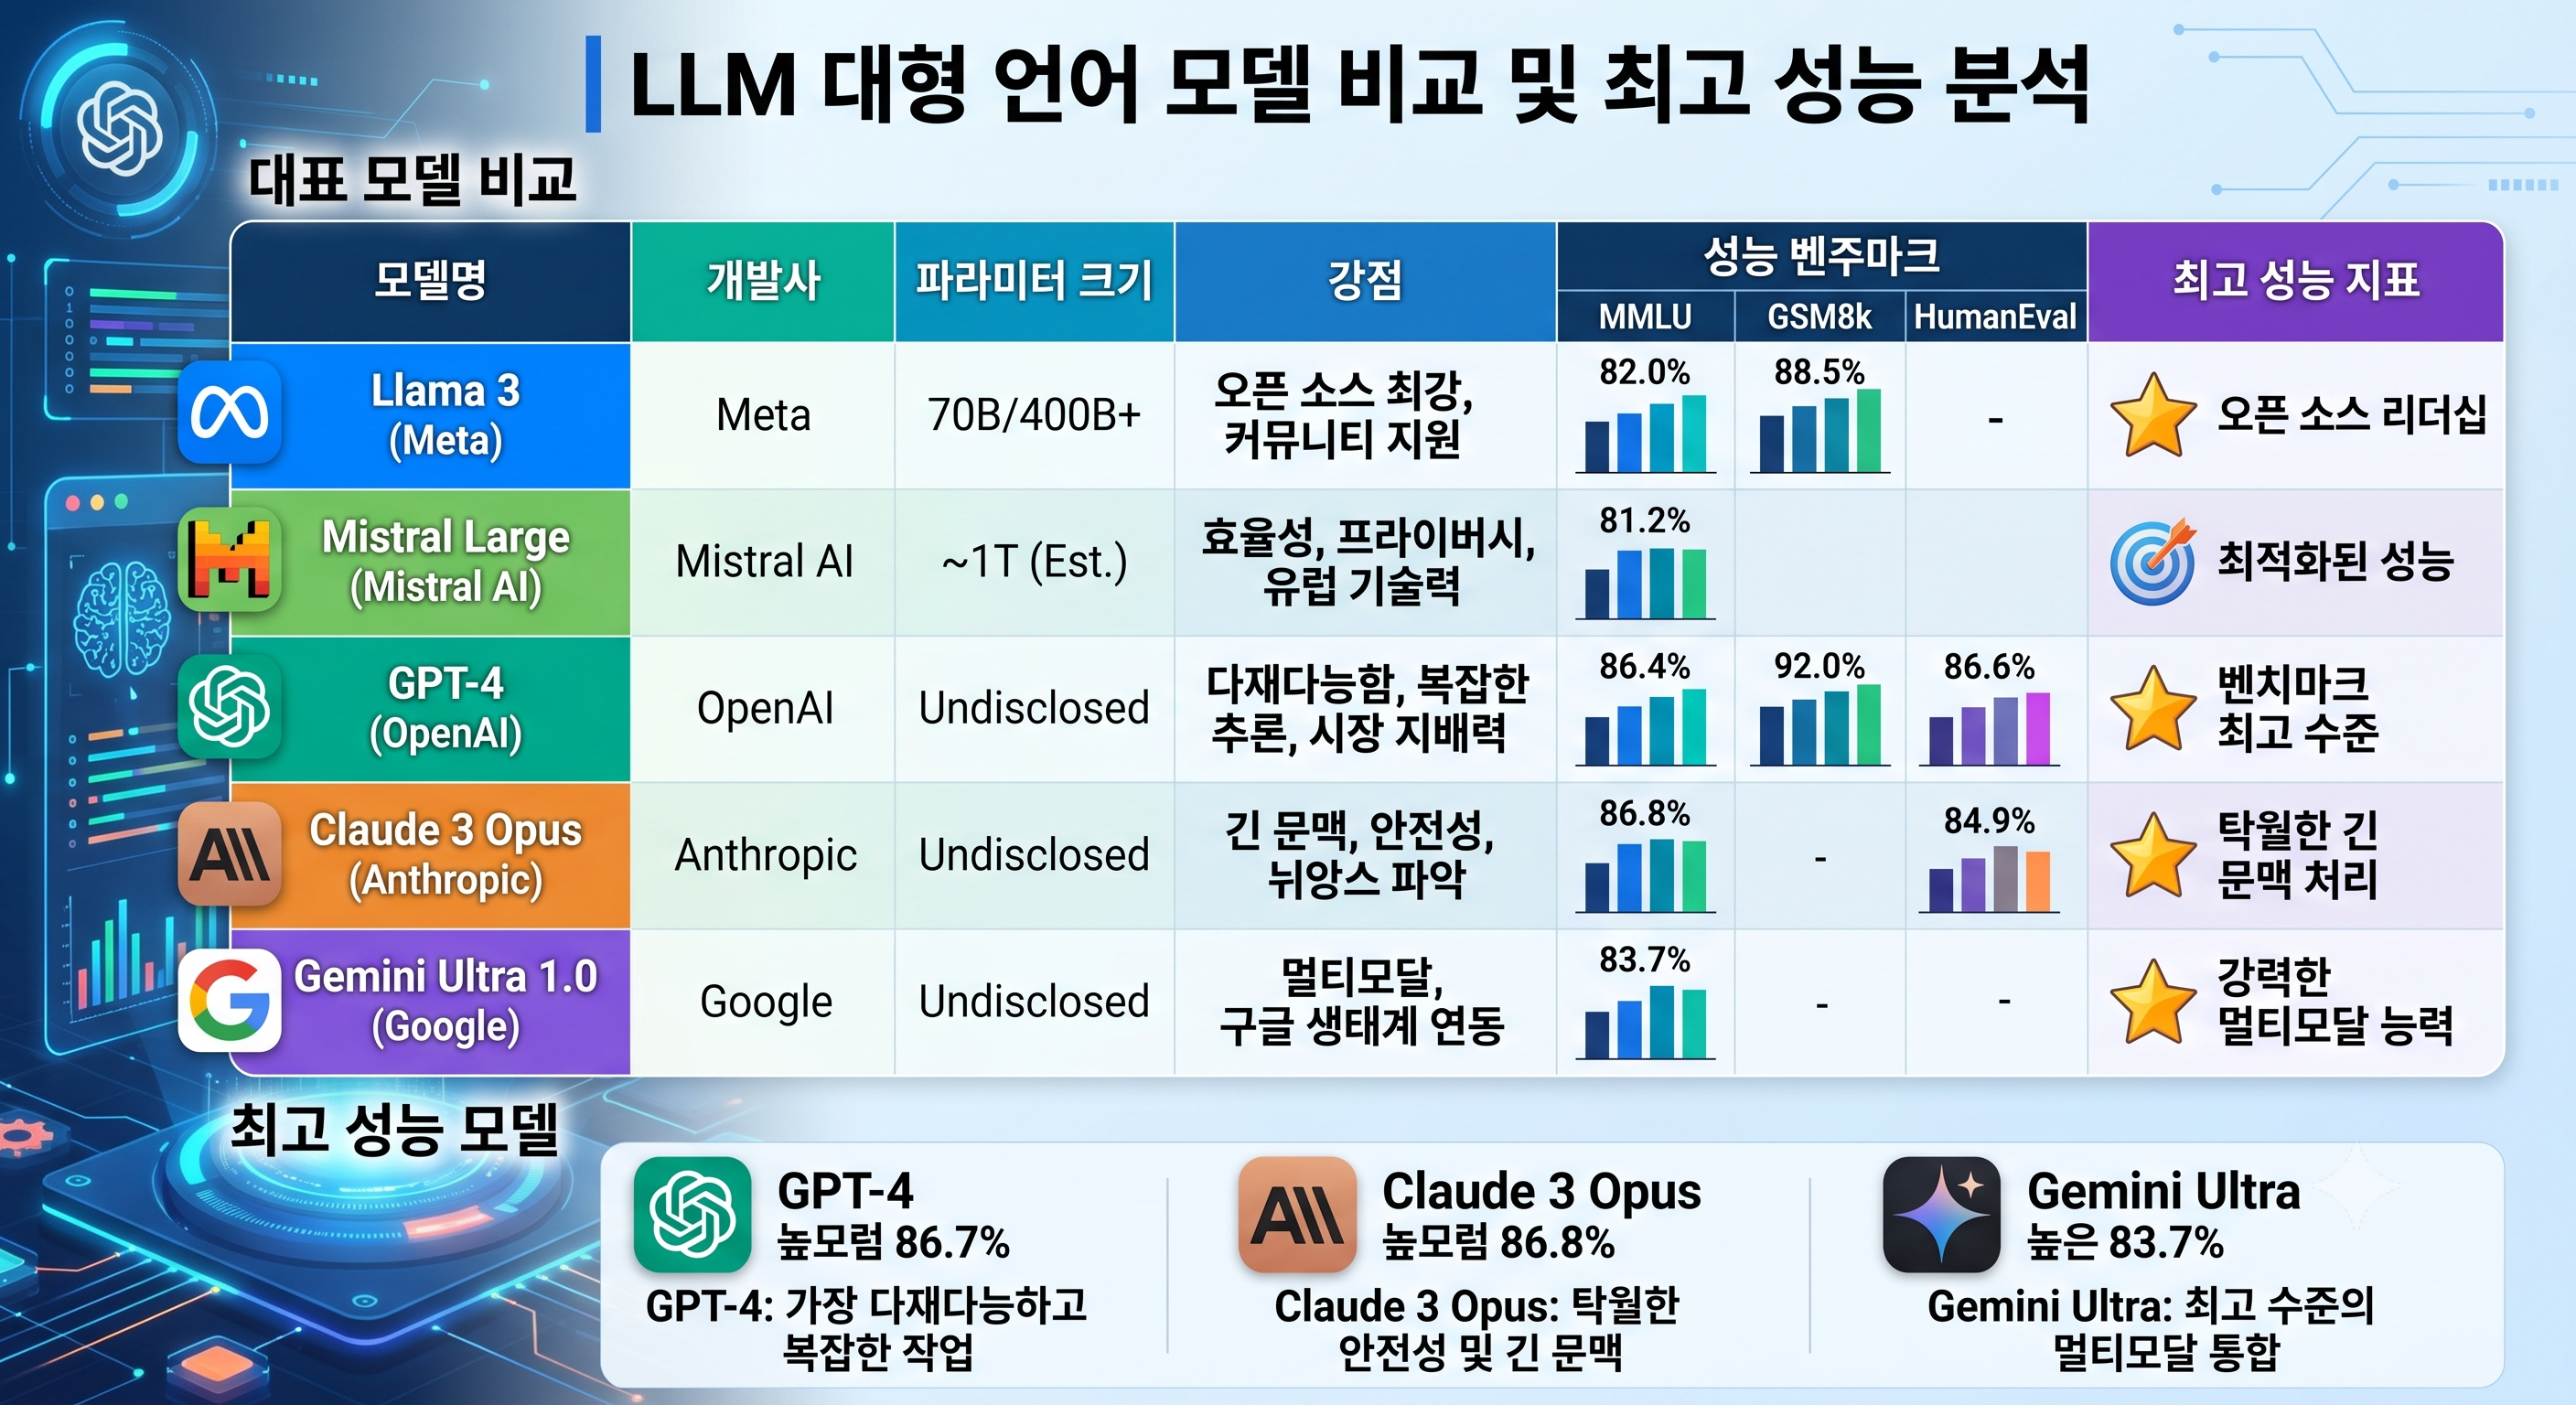
클라우드 API(OpenAI, Gemini 등)에 의존하지 않고 로컬 환경에서 오픈 가중치 거대언어모델(LLM)을 구동하면 보안성, 비용 절감, 오프라인 작업 환경을 모두 확보할 수 있습니다[cite: 1, 2]. 표준으로 자리 잡은 Llama와 Mistral 외에도 뛰어난 대안 모델들의 특징과 장단점을 분석하고 최적의 모델을 추천합니다[cite: 1].
| 모델명 | 주요 장점 | 단점 및 한계 | 추천 용도 |
|---|---|---|---|
| Llama | 가장 풍부한 커뮤니티 자료 및 파인튜닝 생태계, 안정적인 아키텍처[cite: 1] | 기본 모델의 한국어 등 비영어권 어휘 생성 품질 편차 존재[cite: 1] | 범용 지시 이행, 로컬 파인튜닝 베이스 모델[cite: 1] |
| Mistral | 작은 파라미터 대비 빠른 추론 속도 및 슬라이딩 윈도우 어텐션 효율성[cite: 1] | 대규모 문맥 처리 시 일부 디테일 누락 가능성[cite: 1] | 영문 텍스트 요약, 에이전트 워크플로우[cite: 1] |
| Qwen | 한국어 자연스러움 최상위권, 강력한 다국어 및 긴 컨텍스트 처리[cite: 1] | 상위 파라미터(32B/72B) 구동 시 고사양 VRAM 요구[cite: 1] | 국내 문서 요약, 한국어 RAG 구축, 다국어 번역[cite: 1] |
| DeepSeek | 상용 서비스급 코딩 성능, 복잡한 알고리즘 및 수학 추론 발군[cite: 1] | MoE 계열은 파라미터 크기로 인해 최소 시스템 메모리 요구치 높음[cite: 1] | 소프트웨어 개발 보조, 코드 리뷰 및 디버깅[cite: 1] |
| Gemma | 우수한 텍스트 분석력, 높은 벤치마크 점수, 구글 에코시스템 도구 연계[cite: 1] | 엄격한 안전성 가이드라인으로 인한 일부 요청 거부 현상[cite: 1] | 구조화 데이터 추출, 안전한 정보 요약[cite: 1] |
| Phi | 극소형(SLM) 사이즈 대비 뛰어난 추론 효율, 저사양 온디바이스 최적화[cite: 1] | 비영어권 언어 표현력 및 방대한 지식 기반 작업에 한계[cite: 1] | 노트북 로컬 비서, 소형 디바이스 임베디드 AI[cite: 1] |
Llama의 한국어 번역투나 어색한 문맥 형성이 고민이라면 Qwen이 가장 완성도 높은 대안입니다[cite: 1]. 한국어 질의에 대한 문맥 파악 및 지시 수행 능력이 뛰어나 로컬 문서 검색(RAG) 구축 시 최상의 정확도를 제공합니다[cite: 1].
로컬 PC에서 외부 API 유출 없이 코딩 지원 챗봇을 구현하고자 할 때는 DeepSeek 계열이 업계 최고 수준의 성능을 보여줍니다[cite: 1]. 문법 오류 탐지뿐만 아니라 복잡한 다단계 알고리즘 설계에서 정확한 결과를 출력합니다[cite: 1].
메모리 제약이 있는 일반 업무용 노트북이나 보급형 그래픽 카드 환경에서는 Phi 또는 Gemma의 양자화 버전을 권장합니다[cite: 1]. 최소한의 하드웨어 리소스로도 텍스트 분류와 요약 과업을 원활하게 수행합니다[cite: 1].
GGUF를 사용해 CPU/GPU 분할 오프로딩을 적용하고, Apple Silicon Mac에서는 통합 메모리 대역폭을 최대로 살려주는 MLX 포맷을 우선 고려합니다[cite: 1, 2].다국어 및 한국어 비즈니스 문서 처리가 중심이라면 Qwen, 코딩 개발 환경 구축이라면 DeepSeek, 저사양 온디바이스 실행이라면 Phi/Gemma를 선택하는 것이 로컬 LLM 환경에서 최상의 성능을 확보하는 전략입니다[cite: 1].

댓글목록
등록된 댓글이 없습니다.