LLM은 Large Language Model, 즉 대형 언어 모델을 말합니다. 대규모 텍스트 데이터로 학습되어 자연어 질문을 이해하고, 문맥에 맞는 답변을 생성하는 인공지능 모델입니다.
LLM은 학습 데이터에서 본 언어 패턴을 바탕으로 다음 단어를 예측하는 모델입니다. 사용자가 입력한 문장을 읽고, 가장 자연스러운 다음 토큰을 계속 만들어냅니다.
LLM을 의미를 완전히 이해하는 존재보다는, 학습 데이터에서 형성된 언어 패턴으로 답변을 생성하는 도구로 이해하는 것이 적절합니다.
| 개념 | 쉽게 이해하기 |
|---|---|
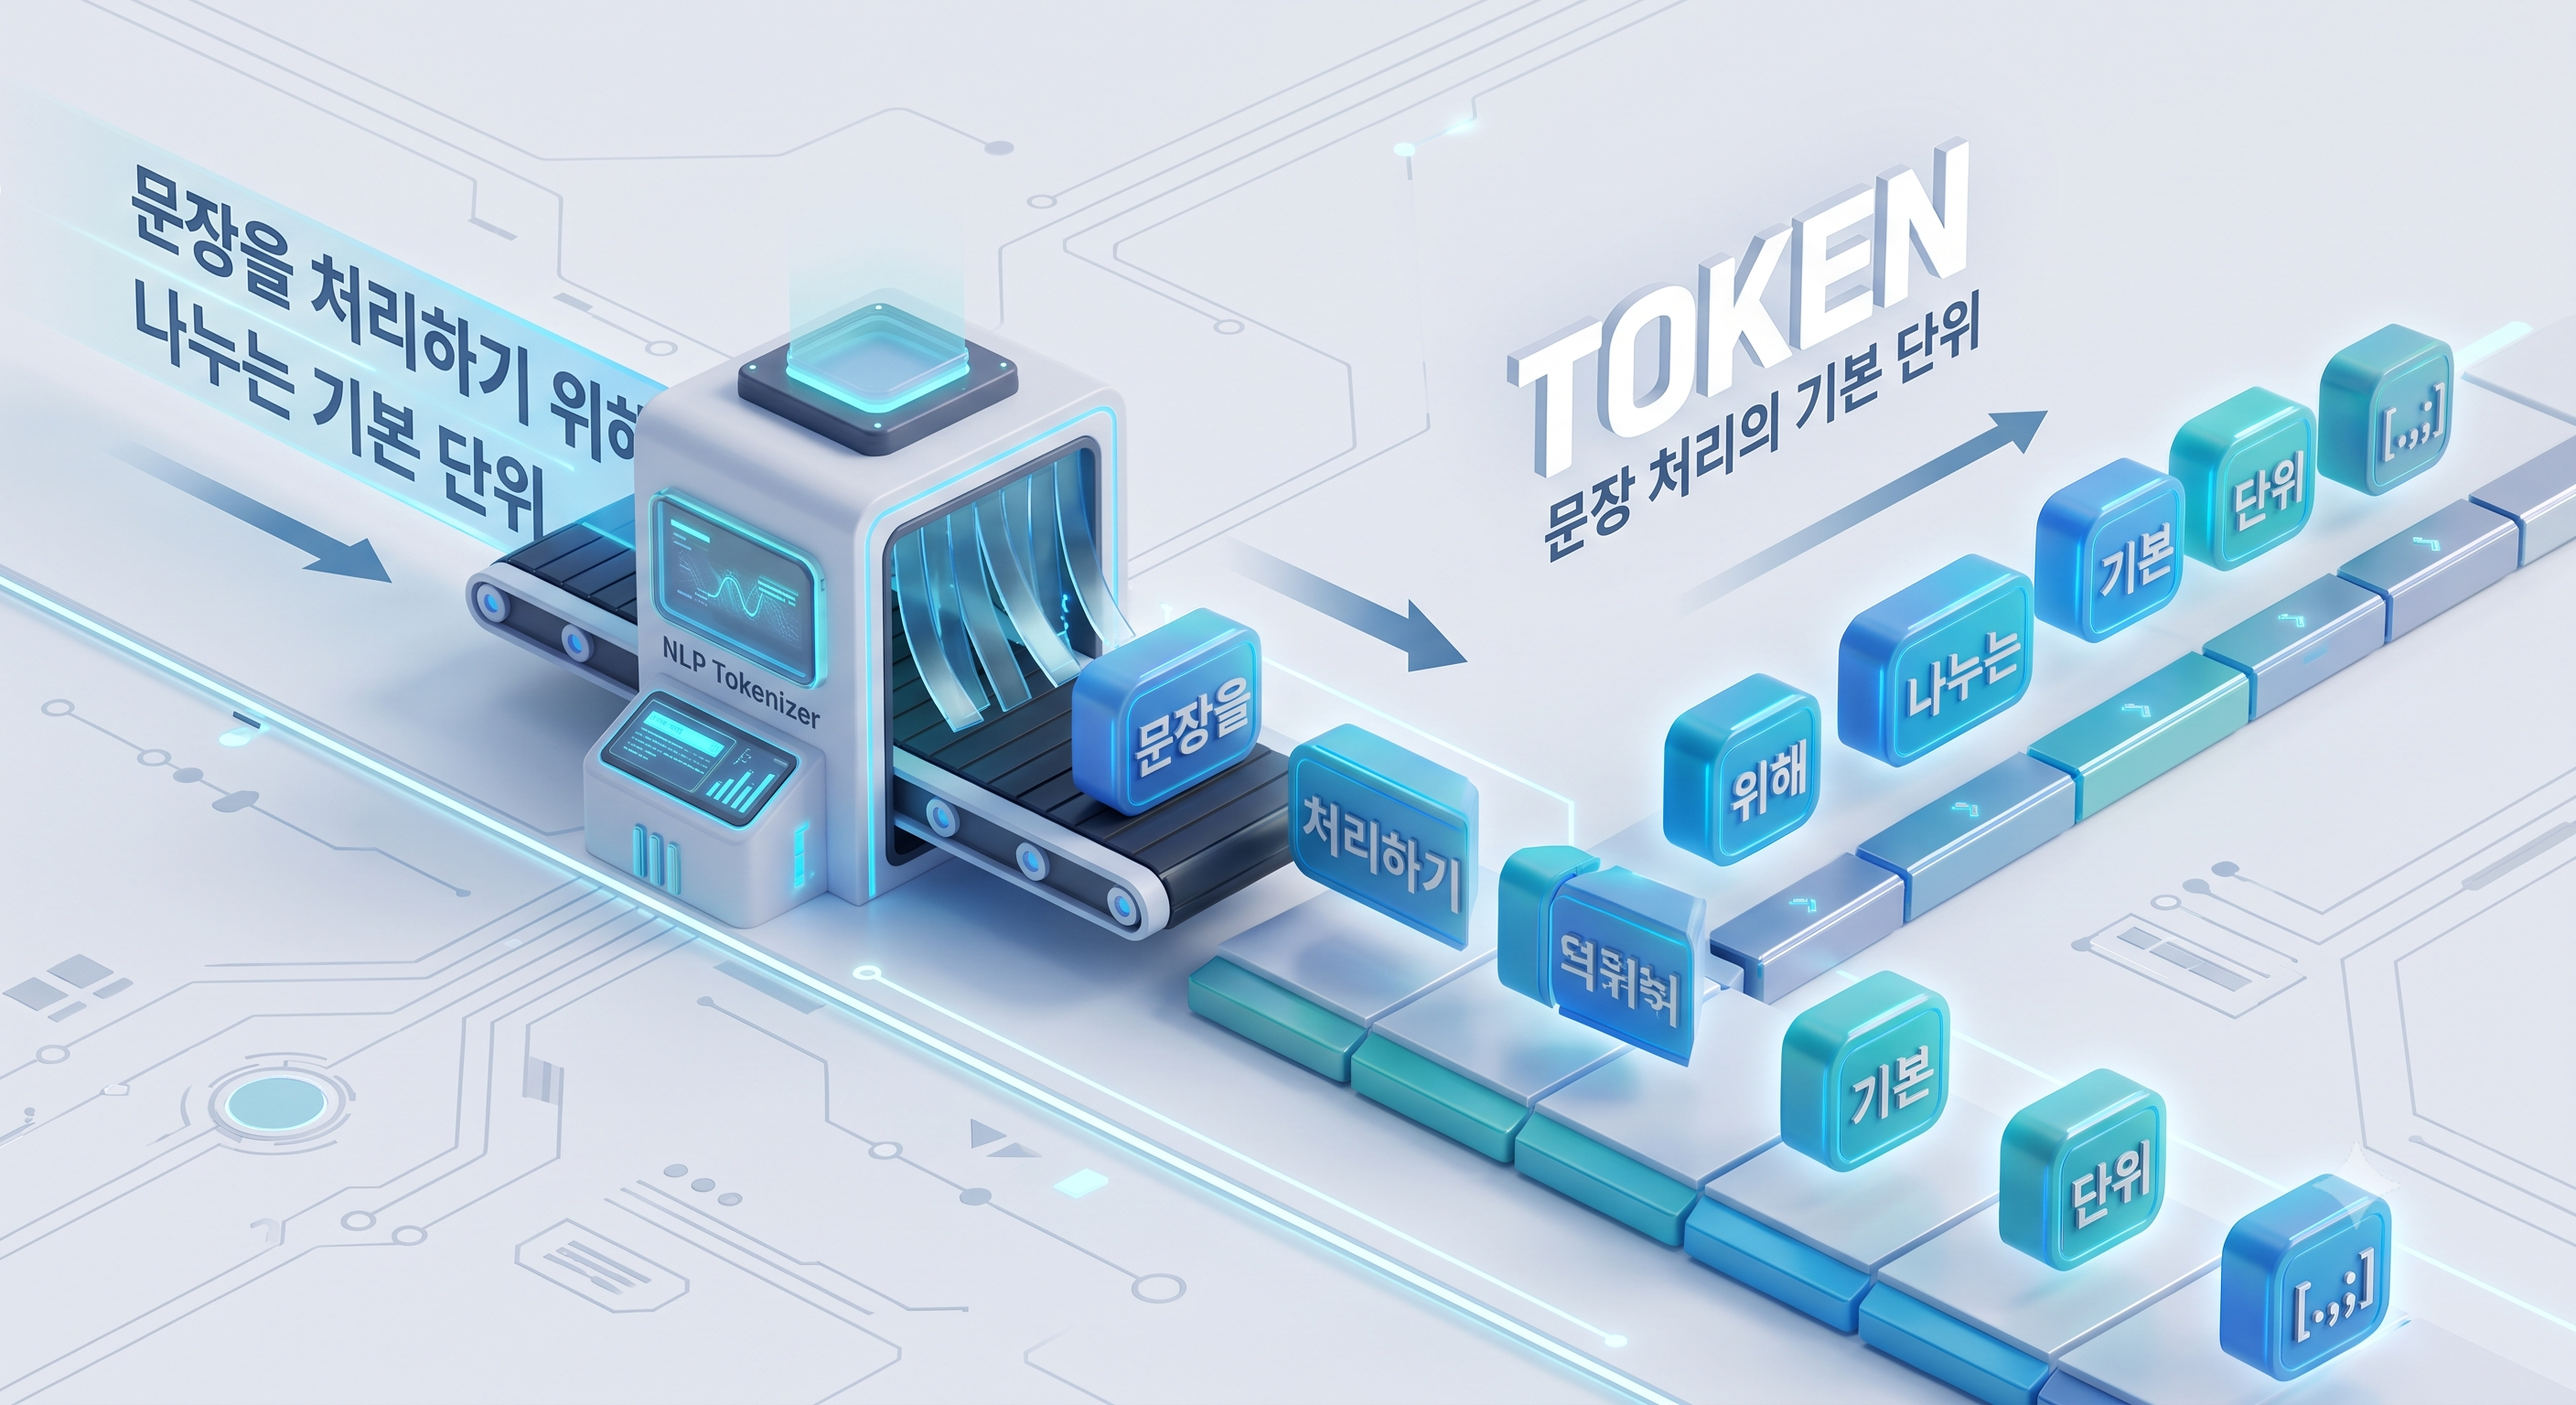
| Token | 문장을 처리하기 위해 나누는 기본 단위입니다. 단어, 문장 부호, 표제어 등일 수 있습니다. |
| Embedding | 토큰을 숫자 벡터로 변환한 표현입니다. 의미적으로 비슷한 단어는 가깝게 배치됩니다. |
| Transformer | 토큰 사이의 관계를 분석하는 신경망 구조입니다. 문맥에서 중요한 단어가 어떻게 연결되는지 계산합니다. |
| Context Window | 모델이 한 번에 처리할 수 있는 토큰 범위를 말합니다. |
| Next-token Prediction | 다음에 올 토큰을 예측하는 방식입니다. 대부분의 최신 LLM은 이 방식으로 학습됩니다. |
| Prompt | 사용자가 LLM에 주는 질문, 지시, 자료입니다. |
| Hallucination | 사실이 아닌 내용을 그럴듯하게 생성할 수 있는 특성입니다. |

LLM의 기본 처리 흐름
입력이 오늘 날씨가 좋이라고 하면, LLM은 다음으로 올 수 있는 토큰을 계산합니다. 아요, 다, 은 등이 후보가 될 수 있습니다. 모델은 문맥에 맞게 자연스러운 토큰을 선택하고, 이 과정을 반복하여 완성된 문장을 만듭니다.
구체적인 토큰 분할 방식은 모델에 따라 다를 수 있습니다. 하지만 핵심은 문장을 작은 단위로 나누고, 그 단위의 관계를 이용해 다음 단어를 예측하는 것입니다.
| 활용 영역 | 예시 |
|---|---|
| 요약 | 긴 문서, 회의록, 보고서의 핵심을 정리합니다. |
| 글쓰기 | 블로그, 메일, 발표문, 기획안 초안을 만듭니다. |
| 코드 | 코드 설명, 예시 작성, 오류 원인 추론을 지원합니다. |
| 번역과 톤 변환 | 같은 내용을 다른 형식, 말투, 언어로 바꿉니다. |
| 방법 | 예시 |
|---|---|
| 목적을 명확히 한다 | 이 자료를 블로그 글로 요약해줘. 독자는 IT 초보입니다. |
| 형식을 지정한다 | 3줄 이내로 답변해줘. |
| 제약 조건을 준다 | 기술 용어는 쉬운 비유로 설명해줘. |
LLM은 문장을 토큰으로 나누고, 의미를 숫자로 변환한 뒤, Transformer가 문맥 패턴을 분석해 다음 토큰을 계속 생성하는 모델입니다.
LLM은 다음 단어를 잘 예측하는 언어 도구입니다. 질문을 구체적으로 제공하고, 결과를 확인하며, 작성과 아이디어 도출의 보조 도구로 활용하는 것이 가장 효과적입니다.

댓글목록
등록된 댓글이 없습니다.