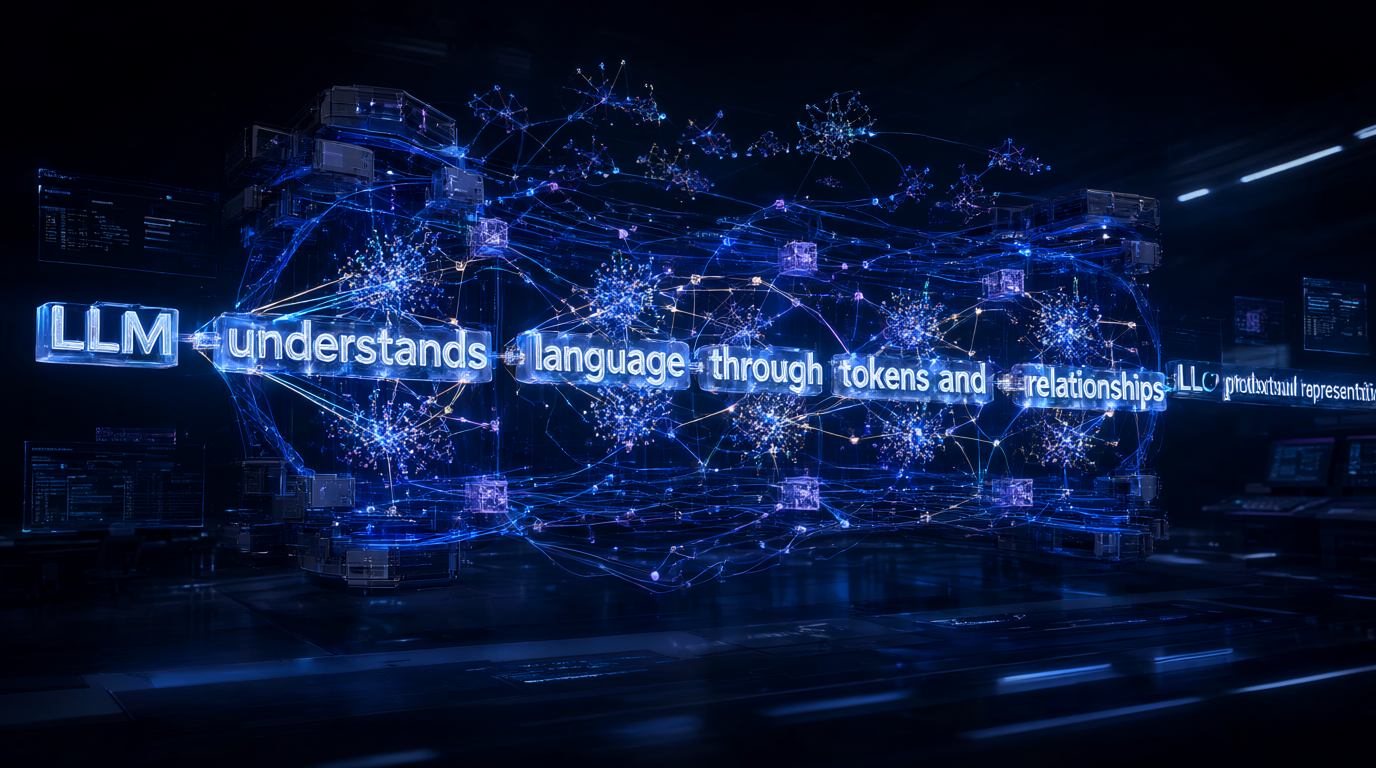
거대언어모델(LLM)은 사람이 글을 읽고 뜻을 깨닫는 것과는 다른 수학적·통계적 메커니즘을 통해 문장을 파악합니다[cite: 1]. 자연어 텍스트를 숫자로 치환하고 문맥 속 단어들의 연결 관계를 계산하여 문장을 '이해'하는 4단계 핵심 과정을 정리합니다[cite: 1].
컴퓨터는 '사과'나 '문장' 같은 글자 자체를 직접 계산할 수 없습니다. 따라서 문장이 입력되면 모델이 처리할 수 있는 가장 작은 의미 단위인 토큰(Token) 단위로 쪼갠 뒤 고유한 숫자 ID를 부여합니다[cite: 1].
단순한 숫자 번호는 단어 간의 유사도나 관계를 담지 못합니다. 모델은 이를 수백~수천 차원의 벡터(Vector, 연속된 숫자 배열) 공간에 좌표값으로 배치합니다.
| 구분 | 역할 및 동작 방식 |
|---|---|
| 의미 임베딩 | 의미가 유사한 단어들(예: '고양이'와 '강아지')이 다차원 공간상에서 서로 가까운 좌표에 위치하도록 학습합니다. |
| 위치 인코딩 (Positional Encoding) | 순서가 중요한 언어의 특성을 반영하여, 문장 안에서 해당 토큰이 몇 번째 위치에 등장했는지에 대한 순서 정보를 벡터에 더합니다. |
LLM 이해의 핵심은 트랜스포머(Transformer) 아키텍처의 셀프 어텐션(Self-Attention) 메커니즘입니다[cite: 1]. 단어의 사전적 정의만 보는 것이 아니라, 한 문장 안에서 어떤 단어가 다른 어떤 단어와 밀접한 연관이 있는지를 계산합니다[cite: 1].
문맥 벡터 계산이 완료되면, LLM은 사전 학습된 방대한 데이터 패턴을 바탕으로 "이 문맥 뒤에 등장할 확률이 가장 높은 다음 단어(토큰)"를 통계적으로 계산합니다[cite: 1].
LLM은 사람처럼 의식이나 생물학적 직관으로 글을 이해하는 것이 아닙니다. 텍스트를 숫자로 치환하고, 단어 간의 관계와 거리를 수학적으로 계산하는 셀프 어텐션 구조를 통해 인간이 보기에 완벽하게 문맥을 이해한 것처럼 정교한 결과를 출력합니다[cite: 1].

댓글목록
등록된 댓글이 없습니다.