LLM(거대언어모델)을 이해하기 위한 핵심 용어 총정리: 기본 개념부터 실무 기술까지
거대언어모델(LLM) 생태계는 방대한 기술 용어와 엔지니어링 개념으로 이루어져 있습니다. LLM의 구조와 작동 원리, 학습 방식, 그리고 실무 배포 단계에서 반드시 알아두어야 할 필수 핵심 용어를 5개 영역으로 나누어 정리합니다.
[Flowchart] LLM 라이프사이클과 핵심 기술 용어 맵
[1. 데이터 입력: 토큰 ➔ 임베딩] ➔ [2. 문맥 처리: 트랜스포머 & 셀프 어텐션] ➔ [3. 모델 규모: 파라미터 & 창발성] ➔ [4. 학습 및 정렬: 사전학습 ➔ 파인튜닝 ➔ RLHF] ➔ [5. 생성 및 최적화: 자기회귀 ➔ RAG & 양자화(GGUF/MLX)]
원시 텍스트 입력부터 실무 추론·배포까지 이어지는 핵심 기술 흐름[cite: 1, 4]
1. 텍스트 입력과 이해를 위한 핵심 용어
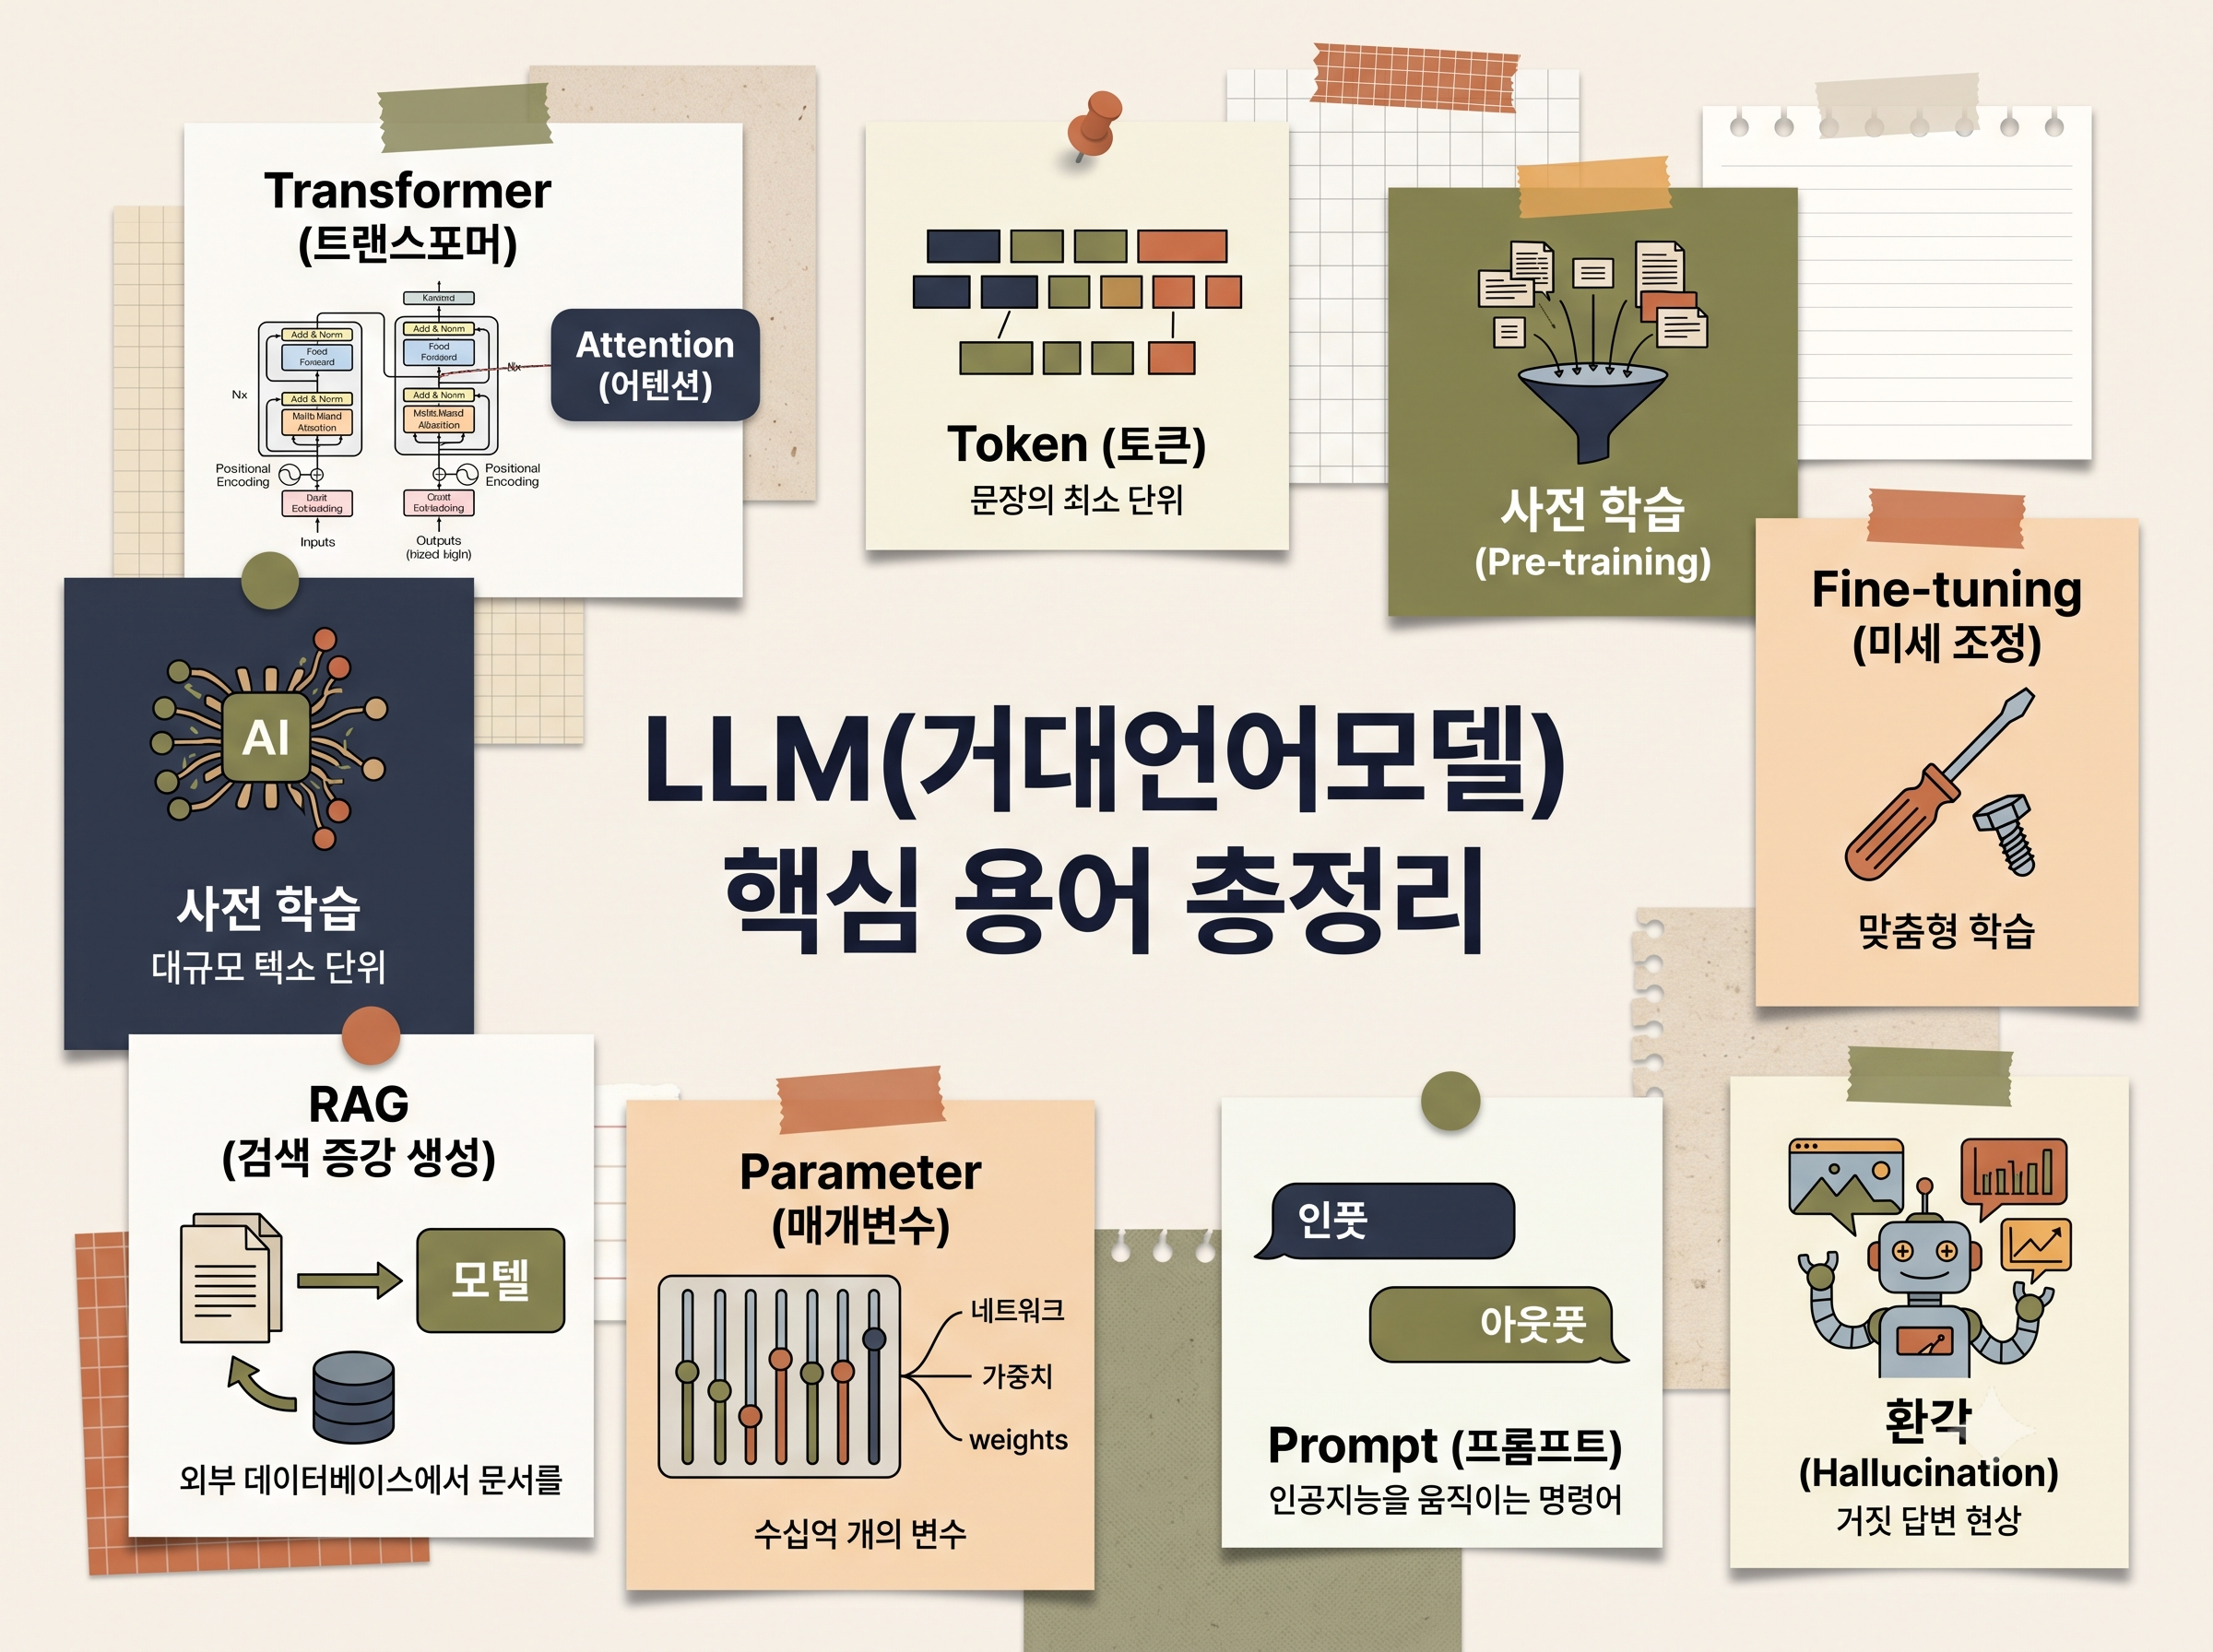
- 토큰(Token) & 토크나이저(Tokenizer): 모델이 처리할 수 있는 가장 작은 의미 단위의 텍스트 조각입니다. 토크나이저는 문장을 단어, 형태소, 서브워드 단위로 쪼개고 이를 정수 ID 번호로 변환합니다.
- 임베딩(Vector Embedding): 정수 ID로 변환된 토큰을 다차원 벡터 공간의 좌표값으로 매핑하는 기술입니다. 의미가 유사한 단어끼리 공간상 가까운 거리에 위치하게 됩니다.
- 위치 인코딩(Positional Encoding): 데이터를 한 번에 병렬 연산하는 구조상 잃어버리기 쉬운 단어의 순서(어순) 정보를 벡터에 더해주는 기법입니다.
- 셀프 어텐션(Self-Attention): 문장 내 모든 단어 간의 상관관계와 가중치를 계산하는 트랜스포머의 핵심 엔진입니다. 대명사가 가리키는 대상이나 다의어의 구체적인 문맥적 의미를 정밀하게 파악합니다.
2. 모델의 두뇌와 규모를 정의하는 용어
- 트랜스포머(Transformer): 셀프 어텐션 메커니즘을 기반으로 문맥 전체를 한 번에 병렬 처리하는 현대 LLM의 표준 인공신경망 백본 아키텍처입니다.
- 파라미터(Parameter, 매개변수): 모델이 대규모 텍스트를 학습하며 축적한 가중치(Weights)의 총합입니다. 모델의 지식과 논리 연산 패턴이 저장되는 척도로 보통 수십억(B)~수천억 개 단위로 표현됩니다.
- 컨텍스트 윈도우(Context Window): 모델이 한 번의 추론 과정에서 기억하고 참조할 수 있는 최대 토큰 한도(입력 프롬프트 + 생성 응답의 총합)입니다.
- 창발적 능력(Emergent Abilities): 파라미터와 데이터 규모가 일정 임계점을 넘어서면서, 사전 학습 과정에서 의도적으로 훈련하지 않은 다단계 논리 추론, 코딩, 수학 연산 능력이 자발적으로 발현되는 현상입니다.
3. 학습과 제어를 위한 핵심 용어
| 용어 |
개념 및 역할 |
주요 목적 |
| 사전 학습 (Pre-training) |
라벨이 없는 방대한 웹 말뭉치에서 다음 단어를 예측하는 자기지도학습 단계 |
언어의 문법 규칙과 보편적인 배경지식 습득 |
| 파인튜닝 (Fine-tuning / SFT) |
질문-답변 쌍 등 정제된 데이터셋을 통해 모델 가중치를 재학습하는 미세조정 |
특정 작업 수행력 부여, 전문 도메인 어조 체화 |
| 정렬 (Alignment / RLHF) |
인간의 피드백을 기반으로 모델의 선호도와 안전성 기준을 일치시키는 기술 |
유해 응답 차단, 사용자의 지시 준수율 극대화 |
4. 응답 생성과 품질 제어를 위한 용어
- 자기회귀(Autoregressive): 모델이 이전에 생성한 토큰을 다시 새로운 입력값의 일부로 삼아 다음 토큰을 하나씩 순차적으로 예측해 나가는 반복 생성 방식입니다.
- Temperature(온도): 다음 단어 확률 분포의 평탄화 정도를 조절하는 샘플링 파라미터입니다. 값을 낮추면 논리적이고 결정론적인 답변이 나오고, 높이면 창의적이고 다양한 어휘가 선택됩니다.
- Top-p (Nucleus Sampling): 확률 상위 p% 누적 영역에 속하는 토큰 중에서만 단어를 선별하여 문맥에서 벗어난 엉뚱한 생성을 방지합니다.
- 환각(Hallucination): 모델이 학습한 데이터에 없는 사실이거나 잘못된 정보를 사실인 것처럼 그럴듯하게 날조하여 출력하는 현상입니다.
5. 실무 도입과 배포를 위한 핵심 용어
- RAG(검색 증강 생성, Retrieval-Augmented Generation): 모델 가중치는 그대로 두고, 사용자의 질문에 맞춰 외부 데이터베이스(사내 문서, 벡터 DB 등)에서 관련 문서를 실시간 검색해 프롬프트에 제공함으로써 환각을 억제하고 최신 출처를 제시하는 기술입니다.
- 양자화(Quantization): 16비트나 32비트로 표현된 모델 가중치를 4비트·8비트 등의 저정밀도 정수형으로 압축하여 VRAM 사용량을 획기적으로 낮추는 기술입니다.
- GGUF:
llama.cpp 기반의 범용 로컬 바이너리 모델 파일 포맷으로, Windows, Mac, Linux 환경에서 CPU와 GPU의 자원을 분할 오프로딩하여 가볍게 실행할 수 있습니다.
- MLX: Apple Silicon Mac 환경의 통합 메모리(Unified Memory) 대역폭을 100% 활용해 고속 추론과 파인튜닝을 지원하는 애플 전용 머신러닝 프레임워크입니다.

결론
LLM은 텍스트를 쪼개어 수치화하는 토큰과 임베딩, 문맥을 입체적으로 계산하는 트랜스포머와 셀프 어텐션, 지식을 정렬하는 RLHF, 그리고 현실적 제약을 극복하는 RAG와 양자화 기술이 유기적으로 맞물려 작동합니다.

댓글목록
등록된 댓글이 없습니다.