처음 시작하는 LLM 가이드: 기본 개념부터 실전 활용까지 한눈에 보기
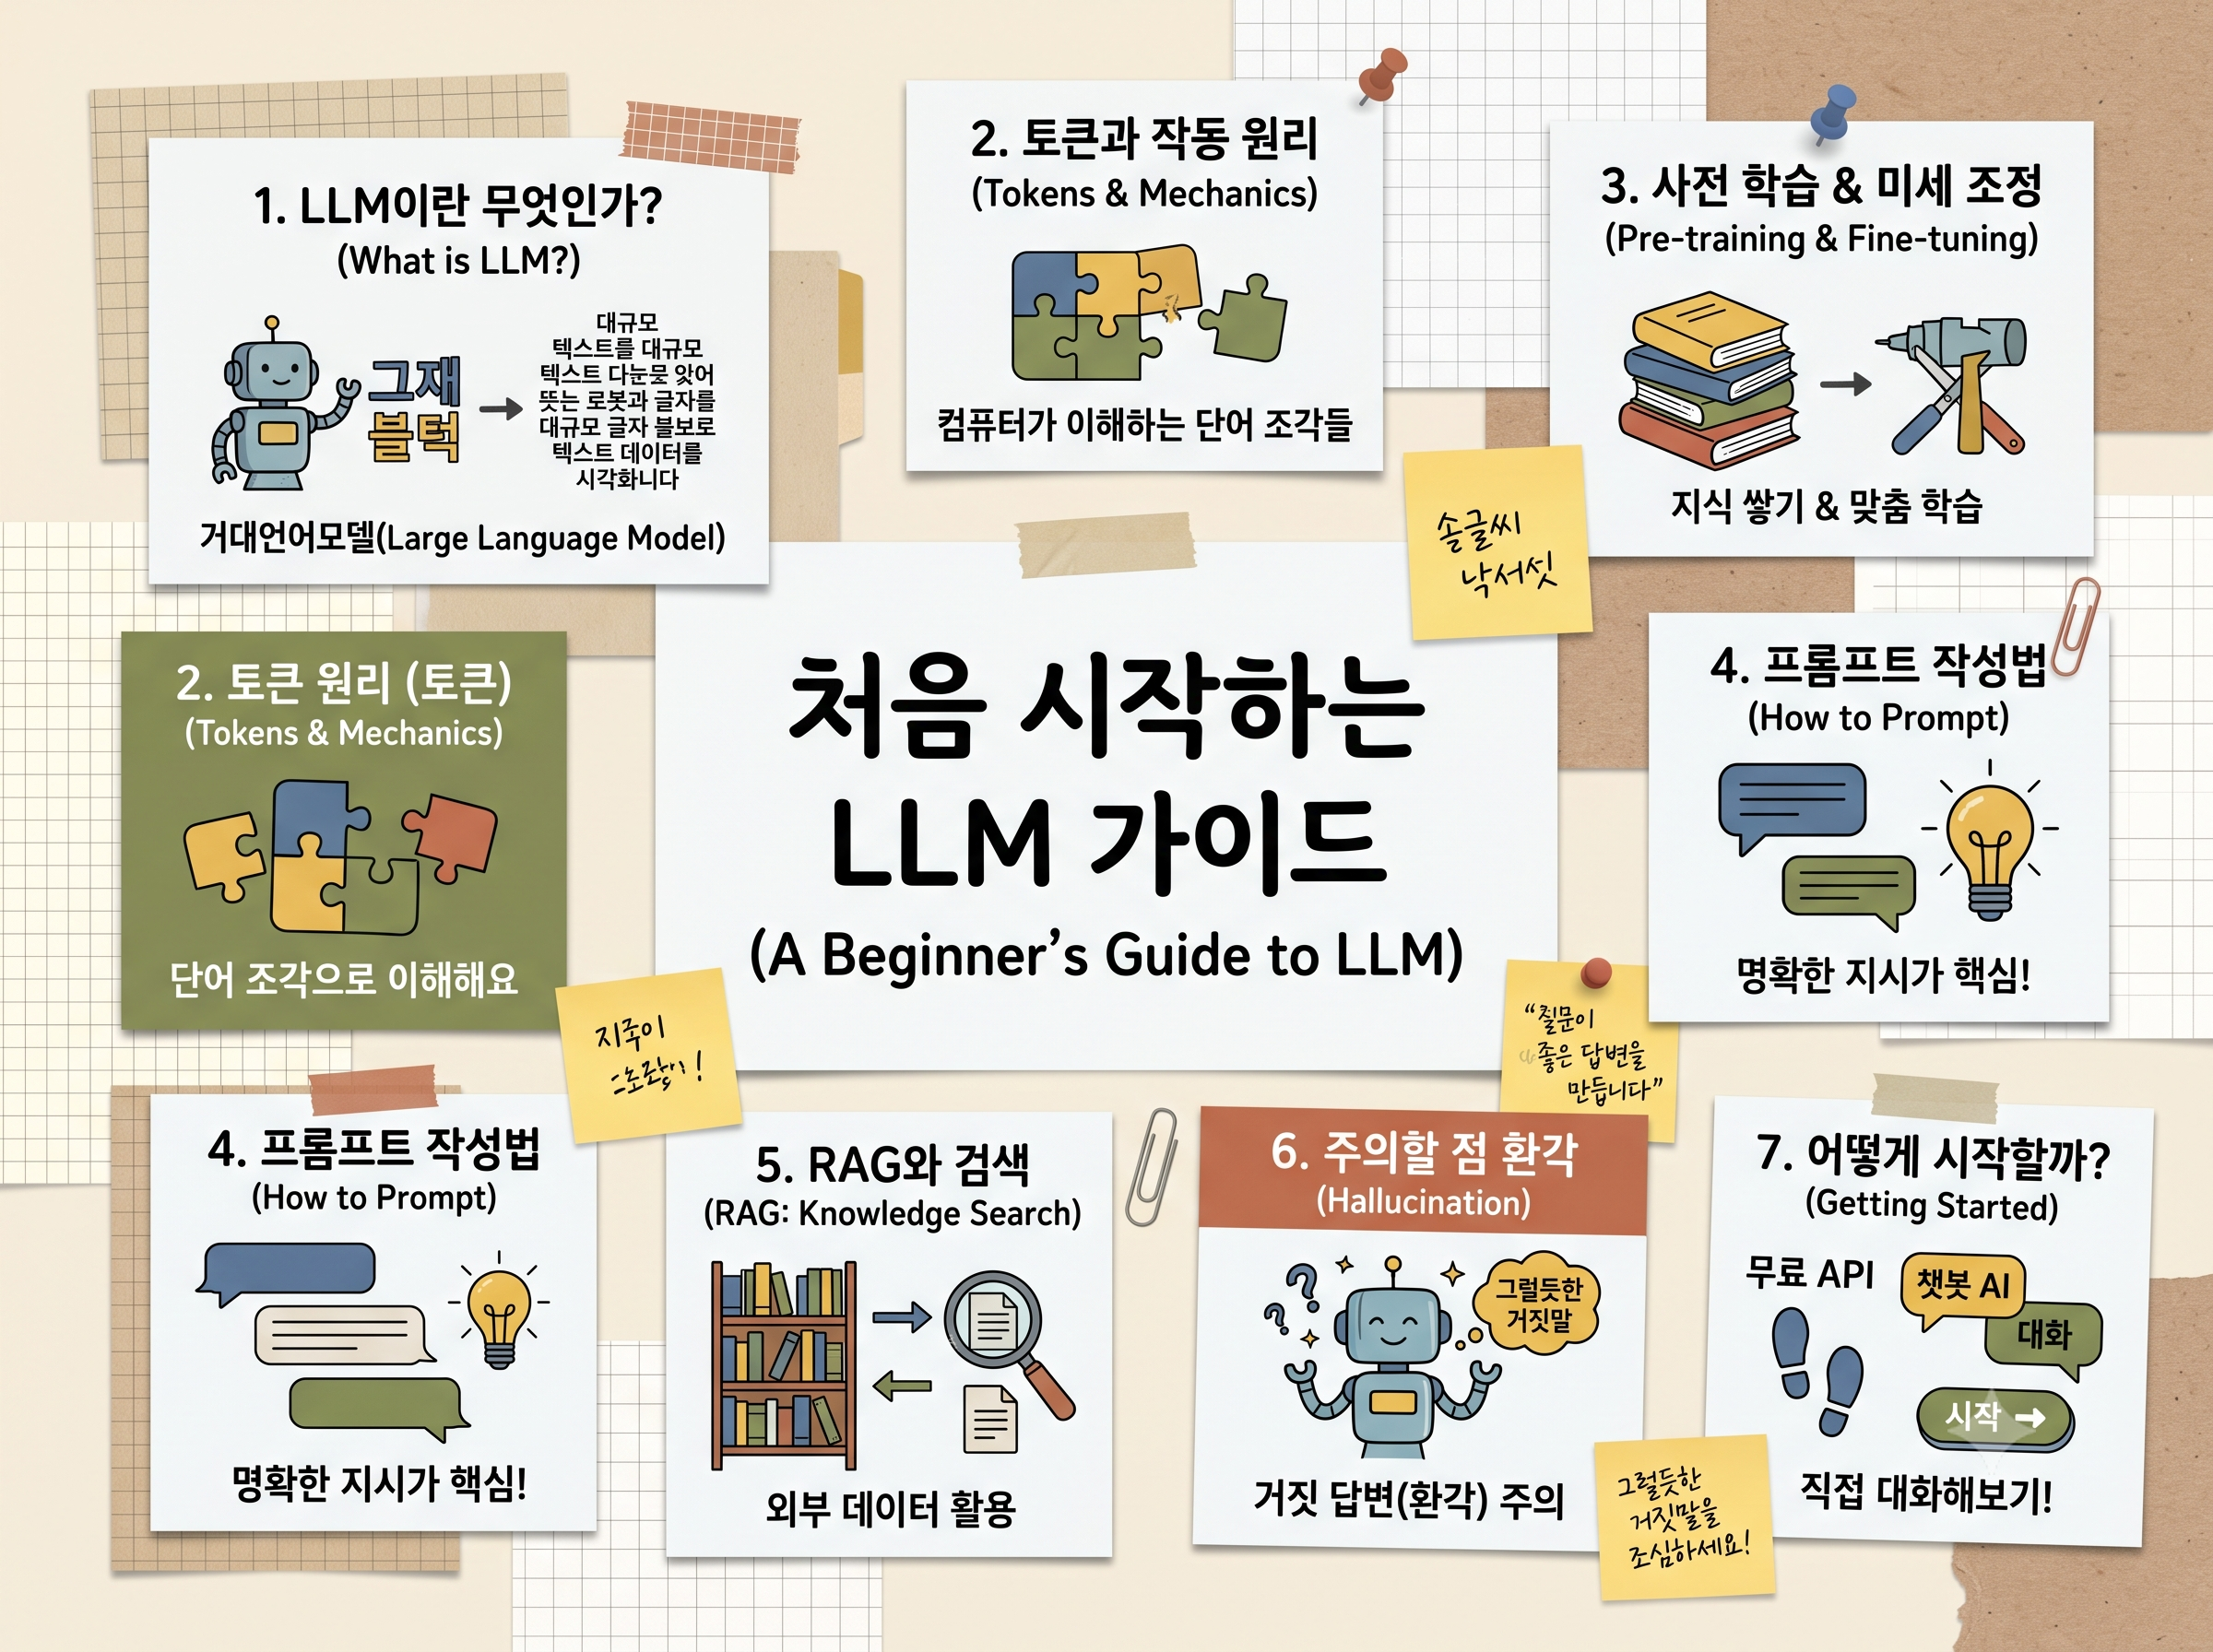
거대언어모델(LLM)은 방대한 텍스트 데이터를 학습해 인간의 언어를 이해하고 자연스럽게 문장을 생성·추론하는 딥러닝 기반 인공지능 모델입니다. 특정 작업 전용으로 개발되던 전통적 AI와 달리 자연어 프롬프트를 통해 대화, 문서 요약, 코딩, 기획 등 다양한 작업을 단일 모델로 수행할 수 있습니다. LLM을 처음 접하는 입문자가 꼭 알아두어야 할 기본 원리와 구동 방식, 실전 활용 팁을 정리합니다.
[Flowchart] 처음 시작하는 LLM 입문 로드맵
[1단계: 핵심 원리 이해 (토큰·트랜스포머)] ➔ [2단계: 환경 선택 (클라우드 API vs 로컬 모델)] ➔ [3단계: 프롬프트 및 파라미터 제어] ➔ [4단계: 한계 보완 (환각 관리 & RAG 연동)]
기초 개념 이해부터 실무 활용까지의 단계별 학습 흐름
1. 입문자를 위한 LLM 핵심 원리 4가지
- 토큰(Token)과 임베딩(Embedding): 모델이 처리할 수 있는 최소 텍스트 단위인 토큰으로 문장을 분할한 후, 단어 간 의미적 거리를 표현하는 다차원 벡터 공간 좌표로 변환합니다.
- 트랜스포머(Transformer)와 셀프 어텐션(Self-Attention): 문장 내 모든 단어 사이의 상관관계와 가중치를 계산하여 대명사가 가리키는 대상과 문맥적 의미를 정밀하게 파악합니다.
- 자기지도학습(Self-supervised Learning): 사람이 일일이 정답 라벨을 붙이지 않아도 방대한 웹 말뭉치 속에서 다음에 올 단어를 스스로 맞추며 언어 규칙과 지식을 습득합니다.
- 자기회귀(Autoregressive) 생성: 이전에 생성된 단어를 다시 새로운 입력값으로 삼아 문장이 끝날 때까지 다음 단어를 순차적으로 이어 붙이며 답변을 완성합니다.
2. 기존 AI와 거대언어모델(LLM) 비교
| 비교 항목 |
기존 AI (전통적 모델) |
거대언어모델 (LLM) |
| 파라미터 규모 |
수백만 ~ 수억 개 단위 |
수십억(B) ~ 수천억 개 단위 이상 |
| 작업 수행 방식 |
분류·번역 등 정의된 특정 단일 과업 전용 |
단일 모델로 대화, 요약, 번역, 코딩 등 범용 수행 |
| 학습 데이터 |
사람이 정답을 라벨링한 정형 데이터 위주 |
웹 규모의 대규모 비정형 텍스트 (자기지도학습) |
| 상호작용 인터페이스 |
정형 데이터 입력 및 API 함수 호출 |
자연어 프롬프트(Prompt) 기반 대화형 입력 |
| 주요 특징 |
단순 패턴 및 통계적 매칭 위주 |
다단계 복합 추론 및 창발적 능력(Emergent Abilities) 발현 |
3. LLM을 시작하는 두 가지 경로: 클라우드 vs 로컬
1) 클라우드 상용 서비스 (Cloud API)
Google Gemini, OpenAI GPT, Anthropic Claude 등 클라우드 인프라 기반의 서비스입니다. 별도의 고사양 하드웨어 없이 웹 브라우저나 API 호출을 통해 가장 뛰어난 성능의 최신 모델을 즉시 활용할 수 있습니다[cite: 2, 4, 7].
2) 오픈 가중치 로컬 구동 (Local LLM)
Meta Llama, Alibaba Qwen, Google Gemma, Microsoft Phi 등의 모델 가중치를 내려받아 개인 PC나 사내 서버에서 직접 구동하는 방식입니다. 외부 인터넷 연결 없이 오프라인에서 데이터를 안전하게 보호할 수 있으며, API 비용 없이 무료로 실행할 수 있습니다.
- GGUF 포맷:
llama.cpp 기반의 바이너리 포맷으로, Ollama나 LM Studio를 사용해 Windows, Linux, macOS에서 CPU와 GPU 자원을 나누어 효율적으로 실행합니다.
- MLX 프레임워크: Apple Silicon Mac 환경의 통합 메모리를 활용해 빠른 추론 속도를 보장하는 애플 전용 기술입니다.
4. 실전 활용 팁과 반드시 알아둘 한계
- 온도(Temperature) 설정: 다음 단어를 고를 때의 무작위성을 제어하는 파라미터입니다. 값을 낮추면(예: 0.2) 논리적이고 일관된 답변을 출력하고, 높이면(예: 0.8) 창의적이고 다채로운 표현을 만듭니다.
- 환각(Hallucination) 주의: 모델은 사실 여부를 검증하는 백과사전이 아니라 통계적으로 그럴듯한 문장을 만드는 엔진이므로, 사실이 아닌 정보를 그럴듯하게 날조할 수 있습니다.
- 지식 단절(Knowledge Cutoff):** 사전 학습이 끝난 시점 이후의 최신 정보나 비공개 사내 문서는 기억하지 못합니다.
- RAG(검색 증강 생성) 연동: 모델을 재학습시키지 않고, 질문이 들어왔을 때 외부 문서나 데이터베이스에서 관련 내용을 실시간 검색해 프롬프트에 주입하는 기술입니다. 이를 통해 환각을 크게 억제하고 정확한 출처를 제공할 수 있습니다.
5. 초보자를 위한 4단계 실전 로드맵
- 자연어 대화형 인터페이스 익히기: 웹 기반 서비스에서 문서 요약, 번역, 초안 작성 등 다양한 지시를 내려보며 프롬프트 입력 방식을 체화합니다.
- 프롬프트 구체화 및 매개변수 테스트: 지시문, 역할, 출력 형식을 명확히 지정하고 Temperature를 조절하여 결과 차이를 비교합니다.
- 로컬 오픈소스 모델 설치해 보기: Ollama나 LM Studio를 설치하고 7B~8B 크기의 경량 모델(Qwen, Llama, Gemma 등)을 개인 PC에 올려 구동해 봅니다.
- 사내 문서 및 RAG 시스템 접목: PDF나 매뉴얼 문서를 검색기와 연결하여 출처 기반의 정확한 답변 시스템을 만듭니다.
결론
LLM은 정답을 복사해 오는 단순 검색기가 아니라, 자연어를 매개로 문맥을 이해하고 논리적으로 추론하는 범용 지능 엔진입니다. 클라우드 서비스로 프롬프트의 기본을 익힌 뒤, 로컬 오픈 모델과 RAG 기술을 단계적으로 접목하면 누구나 강력한 AI 작업 환경을 구축할 수 있습니다.

댓글목록
등록된 댓글이 없습니다.