LLM(거대언어모델)의 핵심 개념 총정리: 기본 원리부터 실무 기술까지
거대언어모델(LLM, Large Language Model)은 방대한 텍스트 데이터를 학습해 인간의 언어를 이해하고 자연스럽게 문장을 생성·추론하는 딥러닝 기반 인공지능 모델입니다. LLM의 구조와 작동 원리, 학습 및 추론 프로세스, 그리고 실무 적용을 위해 반드시 알아두어야 할 핵심 개념을 5개 영역으로 나누어 정리합니다.
[Flowchart] LLM 핵심 개념 및 처리 파이프라인 맵
[1. 입력 및 수치화: 토큰 ➔ 임베딩 & 위치 인코딩] ➔ [2. 문맥 연산: 트랜스포머 백본 & 셀프 어텐션] ➔ [3. 모델 규모: 파라미터 & 창발성] ➔ [4. 학습 및 정렬: 사전학습 ➔ 파인튜닝 ➔ RLHF] ➔ [5. 생성 및 최적화: 자기회귀 ➔ RAG & 양자화(GGUF/MLX)]
원시 텍스트 입력부터 문맥 추론 및 실무 배포까지 이어지는 핵심 기술 체계
1. 텍스트 입력과 이해를 위한 핵심 개념
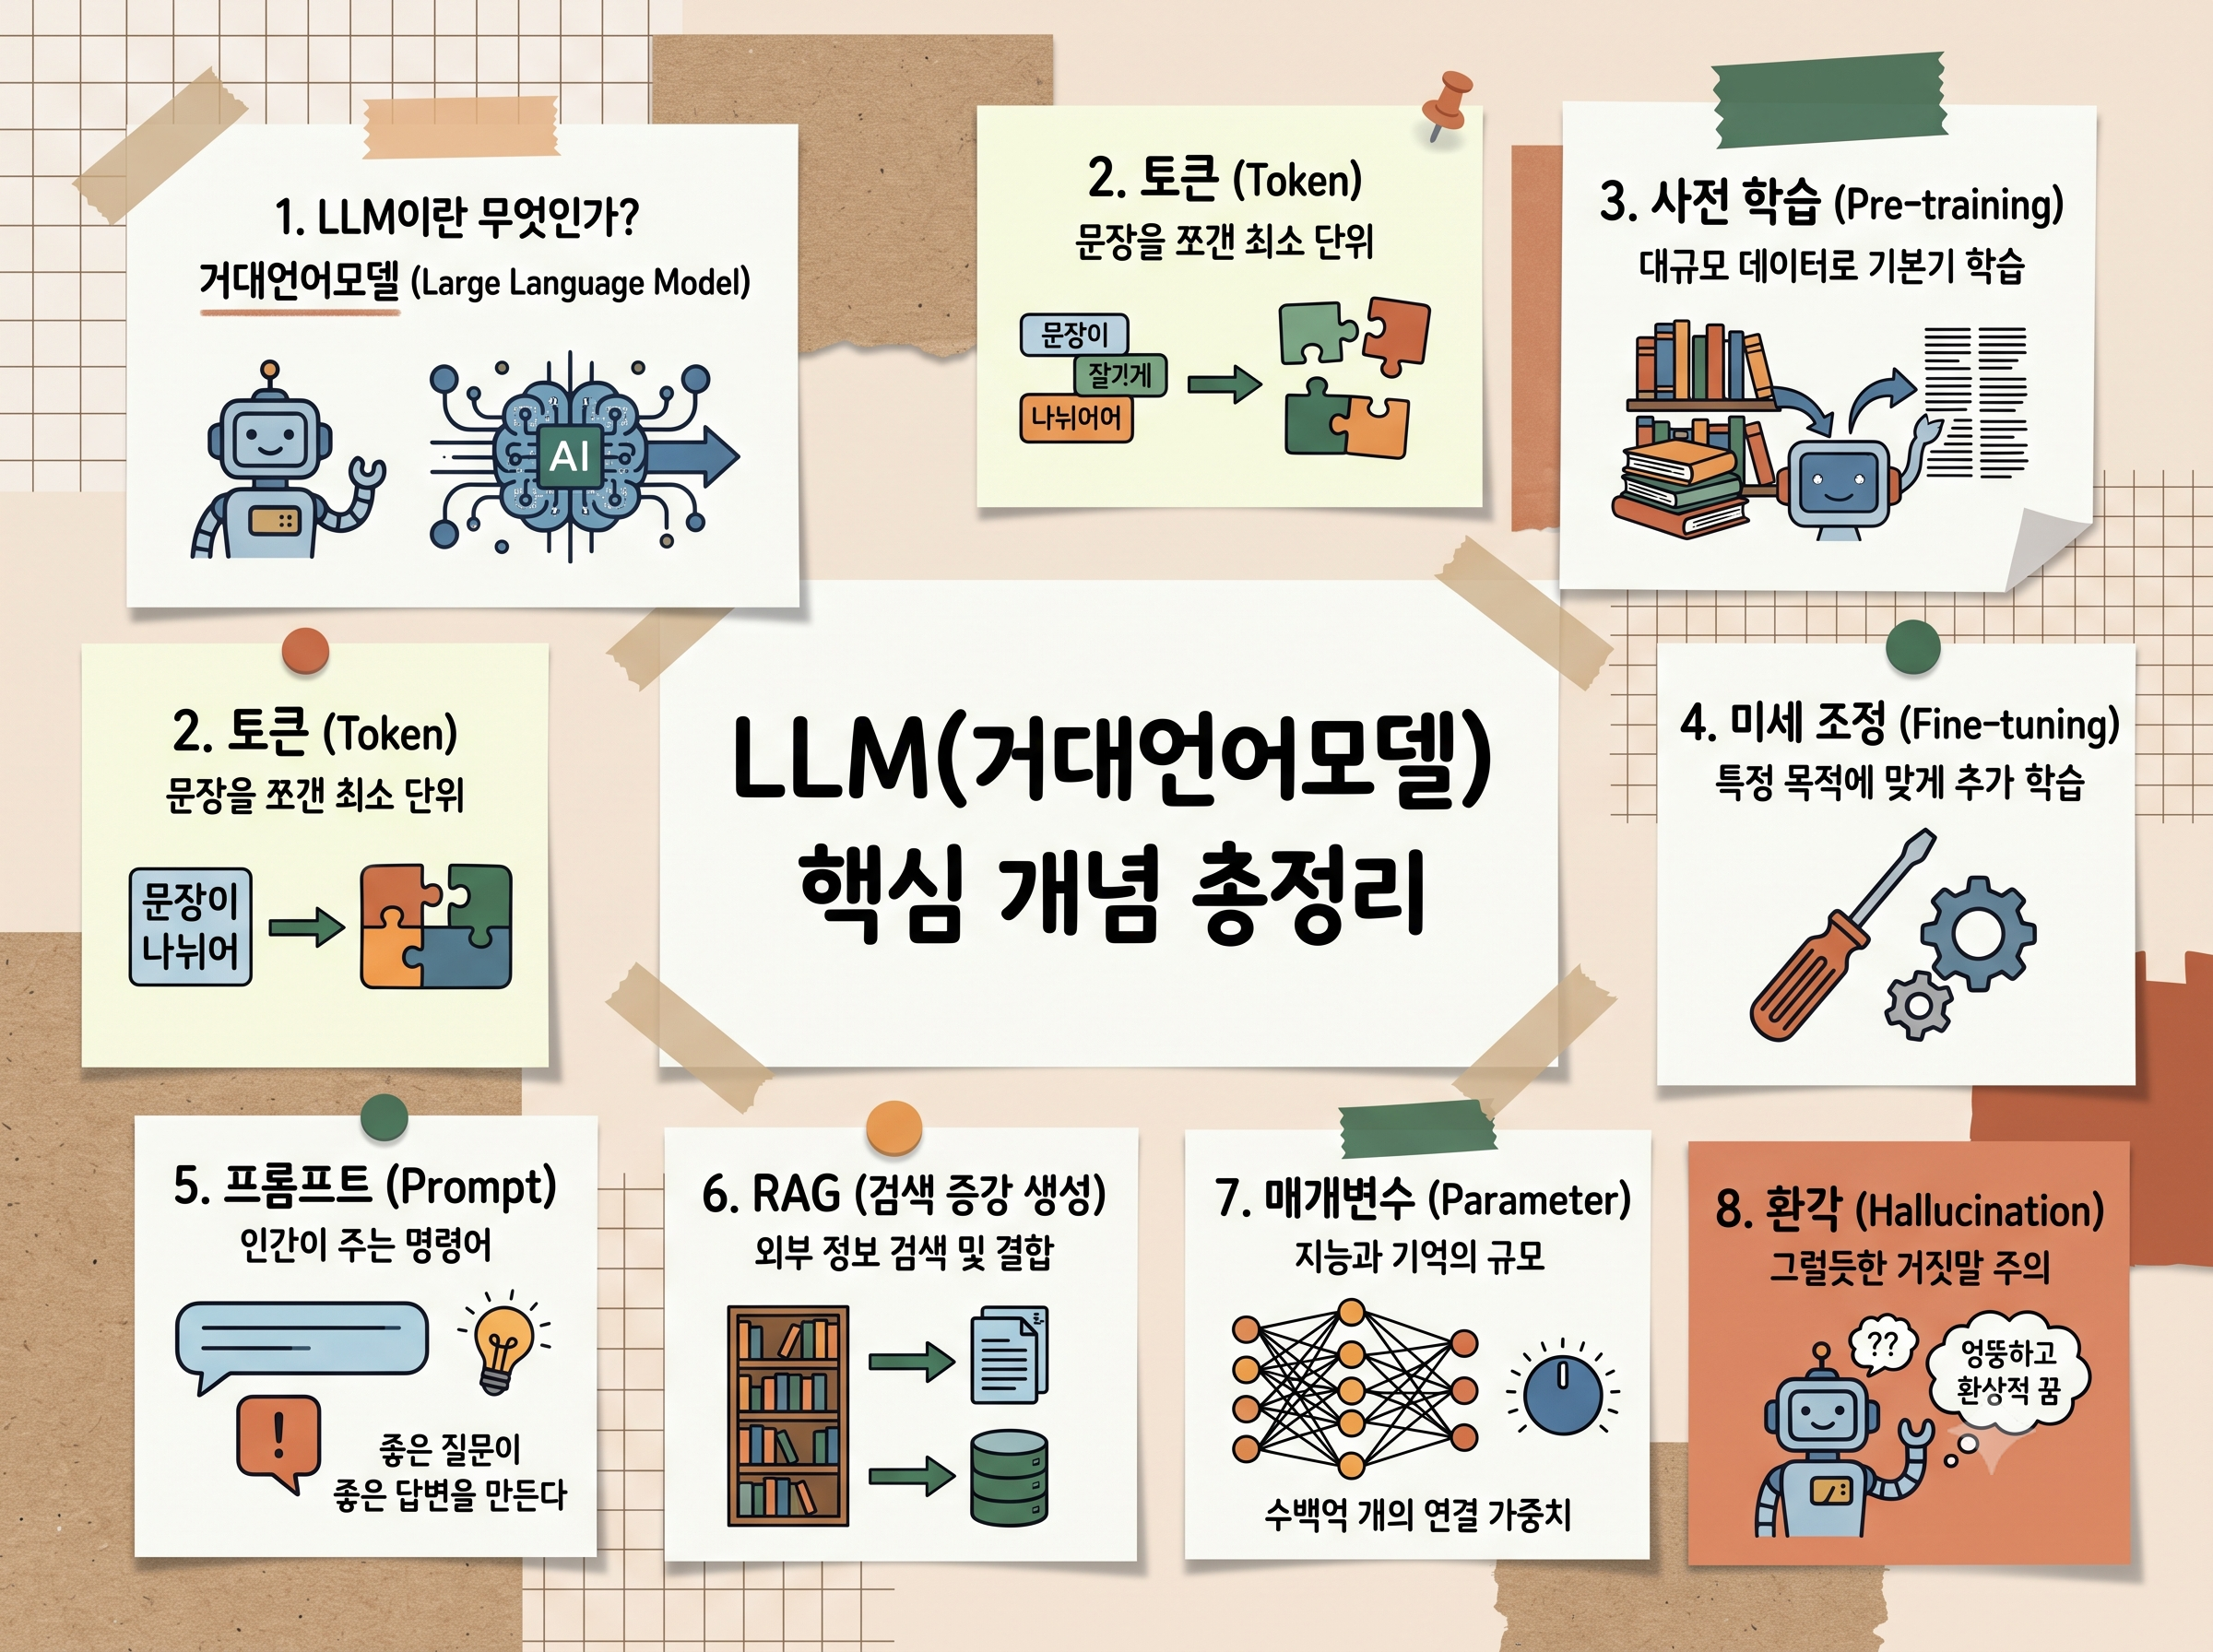
- 토큰(Token) & 토크나이저(Tokenizer): 모델이 처리할 수 있는 최소 의미 단위의 텍스트 조각이며, 토크나이저는 문장을 단어, 형태소, 서브워드로 분할하여 정수 ID로 변환합니다.
- 벡터 임베딩(Vector Embedding): 정수 ID로 변환된 토큰을 수백~수천 차원의 벡터 공간 좌표로 매핑하여 의미적 유사도를 수치화합니다.
- 위치 인코딩(Positional Encoding): 데이터를 한 번에 병렬 연산하는 구조상 사라지기 쉬운 단어의 순서(어순) 정보를 벡터에 합성합니다.
- 셀프 어텐션(Self-Attention): 문장 내 모든 토큰 간의 상관관계와 주목도 가중치를 계산하여 다의어의 정확한 문맥과 대명사가 가리키는 대상을 파악합니다.
2. 모델 구조와 규모를 정의하는 핵심 개념
- 트랜스포머 백본(Transformer Backbone): 셀프 어텐션 메커니즘과 피드포워드 신경망(FFN)을 결합해 문맥 전체를 병렬 처리하는 현대 LLM의 표준 신경망 백본 아키텍처입니다.
- 파라미터(Parameter, 매개변수): 대규모 텍스트를 학습하며 축적한 가중치(Weights)의 총합으로, 모델의 지식과 논리 연산 패턴이 저장되는 척도입니다.
- 컨텍스트 윈도우(Context Window): 모델이 한 번의 추론 과정에서 기억하고 참조할 수 있는 최대 토큰 한도(입력 프롬프트와 출력의 총합)입니다.
- 창발적 능력(Emergent Abilities): 모델 파라미터와 데이터 규모가 임계점을 넘어서면서, 사전 학습에서 명시적으로 가르치지 않은 복합 논리 추론, 코딩, 수학 연산 능력이 발현되는 현상입니다.
3. 학습과 제어를 위한 핵심 개념
- 사전 학습(Pre-training): 라벨 없는 방대한 텍스트 말뭉치에서 다음에 올 단어를 예측하는 자기지도학습(Self-supervised Learning)을 통해 언어 규칙과 배경지식을 습득합니다.
- 파인튜닝(Fine-tuning / SFT): 특정 도메인의 질문-답변 데이터셋을 추가 학습시켜 모델 가중치를 미세조정하고 특정 과업 수행 능력과 고유 어조를 체화합니다.
- 인간 피드백 기반 정렬(RLHF / Alignment): 사람의 선호도와 안전성 기준에 맞게 보상 모델을 적용하여 유해 응답을 차단하고 사용자 지시 이행률을 극대화합니다.
4. 핵심 개념 한눈에 보기
| 영역 |
핵심 개념 |
주요 역할 및 특징 |
| 입력 및 전처리 |
토큰 & 임베딩 |
텍스트를 최소 단위로 분해하고 다차원 의미 좌표 부여 |
| 문맥 연산 |
셀프 어텐션 |
문장 내 단어 간 상관관계를 계산해 문맥 압축 |
| 모델 규모 |
파라미터 & 창발성 |
가중치 규모 임계점 돌파 시 다단계 복합 논리 추론 발현 |
| 지식 및 행동 제어 |
사전학습 & RLHF |
대규모 자기지도학습 후 인간 기준에 맞춘 안전성 및 지시 정렬 |
| 응답 생성 |
자기회귀 & 디코딩 파라미터 |
이전 단어를 기반으로 다음 토큰을 순차 생성하며 창의성·결정성 제어 |
| 실무 최적화 |
RAG & 양자화 |
외부 DB 실시간 검색으로 환각 억제 및 가중치 압축 경량 구동 |
5. 응답 생성과 실무 최적화 개념
- 자기회귀(Autoregressive) 생성: 모델이 이전에 생성한 토큰을 새로운 입력값으로 삼아 종료 토큰이 나올 때까지 다음 토큰을 하나씩 순차적으로 예측·반복합니다.
- 디코딩 파라미터(Temperature & Top-p): Temperature로 확률 분포를 조절해 답변의 논리성과 창의성을 제어하고, Top-p로 상위 누적 확률 토큰만 선별해 엉뚱한 단어 생성을 방지합니다.
- 환각(Hallucination): 모델이 학습한 데이터에 없는 사실이거나 왜곡된 정보를 그럴듯하게 날조하여 출력하는 통계적 언어 모델의 구조적 한계입니다.
- RAG(검색 증강 생성):** 모델 가중치를 수정하지 않고 외부 데이터베이스(벡터 DB 등)에서 관련 문서를 실시간 검색해 프롬프트에 제공함으로써 환각을 억제하고 출처를 제시합니다.
- 양자화(Quantization) 및 로컬 포맷(GGUF, MLX): 16비트 모델 가중치를 4비트 등으로 압축해 VRAM 요구량을 낮추며, 크로스 플랫폼용 GGUF 포맷이나 Apple Silicon에 최적화된 MLX 프레임워크를 통해 개인 PC에서도 효율적으로 실행합니다.
LLM은 텍스트를 숫자로 치환하는 토큰화와 임베딩에서 출발하여, 트랜스포머의 셀프 어텐션을 통한 문맥 연산, 사전학습과 RLHF 정렬, 그리고 자기회귀 생성을 거치는 복합 인공지능 시스템입니다. 여기에 환각을 억제하는 RAG와 하드웨어 연산 부담을 줄이는 양자화 기술이 유기적으로 결합됨으로써 단순한 문장 완성기를 넘어 신뢰성 있는 범용 인텔리전스 엔진으로 확장되고 있습니다.

댓글목록
등록된 댓글이 없습니다.