Token과 Context란 무엇인가? LLM의 텍스트 처리 단위와 문맥 이해 원리
거대언어모델(LLM)을 다룰 때 가장 빈번하게 마주치는 두 가지 기본 개념은 바로 토큰(Token)과 컨텍스트(Context)입니다. LLM은 문장을 사람처럼 통째로 읽는 것이 아니라, 텍스트를 최소 단위인 토큰으로 쪼개어 수치화하고, 셀프 어텐션 메커니즘을 통해 이들 사이의 관계인 컨텍스트를 계산하여 이해합니다. 토큰과 컨텍스트의 기본 개념부터 작동 원리, 그리고 실무적인 중요성까지 체계적으로 정리합니다.
[Flowchart] 토큰 분할부터 컨텍스트 형성 및 응답 생성까지의 흐름
[자연어 텍스트 입력] ➔ [1. 토크나이저: 토큰(Token) 분할 및 정수 ID 변환] ➔ [2. 임베딩 & 위치 인코딩: 벡터 공간 배치] ➔ [3. 셀프 어텐션 연산: 단어 간 상관관계 계산] ➔ [4. 컨텍스트(Context) 형성] ➔ [5. 다음 토큰 예측 및 출력]
원시 텍스트가 토큰 조각으로 나뉘어 문맥적 컨텍스트를 형성하는 처리 과정
1. 토큰(Token)이란 무엇인가?
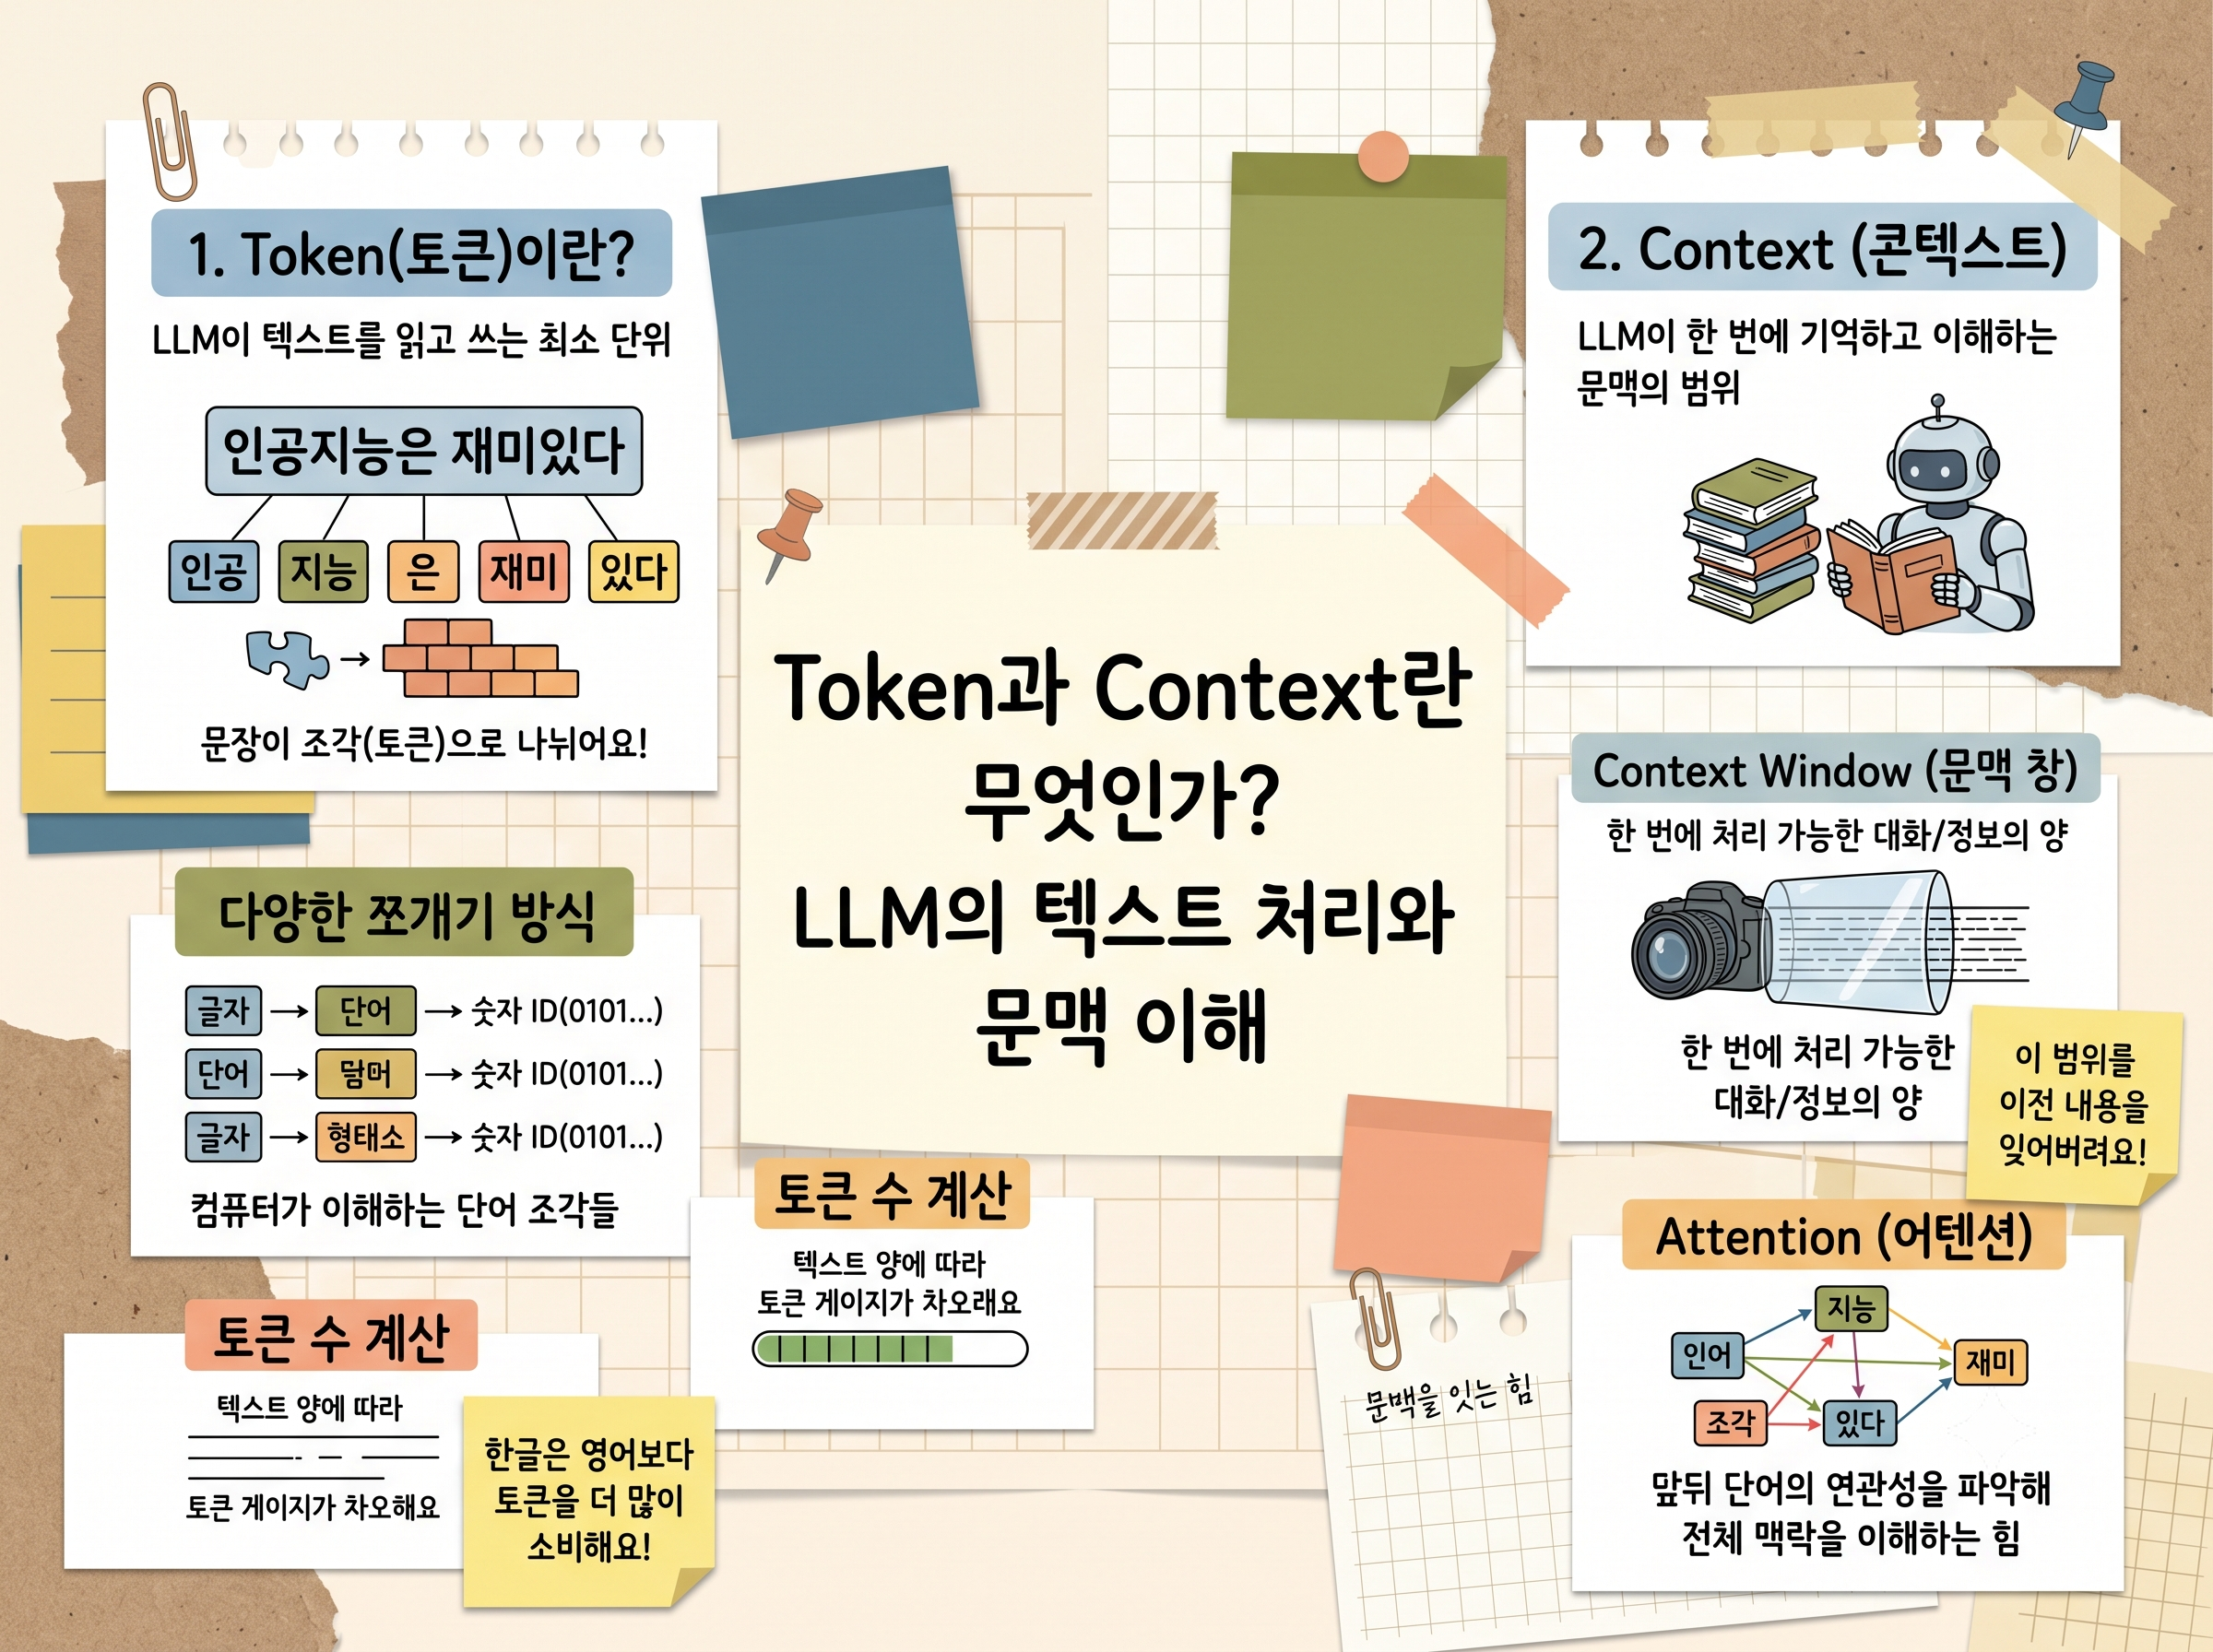
토큰은 모델이 연산하고 이해할 수 있는 가장 작은 의미 단위의 텍스트 조각입니다. 인공지능은 텍스트 문자 자체를 직접 계산할 수 없기 때문에 입력을 숫자로 바꾸는 전처리 과정이 필수적입니다.
- 토크나이저(Tokenizer)의 역할: 문장이 들어오면 토크나이저가 단어, 형태소, 또는 서브워드(Subword) 단위로 문장을 분할하고 사전에 정의된 고유 정수 ID 번호로 변환합니다.
- 토큰 분할 방식: 영어는 대략 1개 단어가 1~2개 토큰으로 나뉘며, 한국어는 교착어 특성상 형태소나 글자 조합에 따라 더 세분화되어 쪼개집니다.
- 벡터 임베딩(Embedding) 변환: 정수 ID로 치환된 토큰은 다차원 벡터 공간의 좌표값으로 매핑되어 의미적 유사도와 거리를 부여받게 됩니다.
2. 컨텍스트(Context)와 컨텍스트 윈도우란?
컨텍스트는 개별 토큰들이 문장이나 대화 안에서 맺고 있는 주변 관계와 앞뒤 맥락의 총합을 의미합니다.
- 셀프 어텐션(Self-Attention)과 문맥 형성: 트랜스포머 아키텍처는 문장 내 모든 토큰 사이의 상관관계와 가중치를 계산하여 컨텍스트를 구축합니다. 이를 통해 "사과를 먹었다(과일)"와 "사과를 건넸다(용서)"처럼 다의어의 모호성을 해결하고 대명사가 지칭하는 대상을 명확히 특정합니다.
- 컨텍스트 윈도우(Context Window): 모델이 한 번의 추론 과정에서 동시에 기억하고 참조할 수 있는 최대 토큰 한도(입력 프롬프트 + 모델 생성 응답의 총합)입니다.
- 기억 용량의 척도: 컨텍스트 윈도우가 넓을수록 책 한 권 분량의 긴 문서나 장기적인 이전 대화 기록을 끊김 없이 참조하며 일관된 답변을 유지할 수 있습니다.
3. 토큰 vs 컨텍스트 한눈에 비교하기
| 비교 항목 |
토큰 (Token) |
컨텍스트 (Context) |
| 개념적 정의 |
텍스트 처리 및 연산의 최소 단위 조각 |
토큰들이 결합되어 형성하는 앞뒤 의미와 상황 맥락 |
| 비유적 표현 |
문장을 구성하는 '벽돌' 또는 '레고 블록' |
벽돌들이 쌓여 만들어진 '완성된 방'의 구조 |
| 모델 내 처리 단계 |
토크나이저와 임베딩을 거치는 입력 전처리 단계 |
셀프 어텐션을 통해 계산되는 신경망 백본 연산 단계 |
| 기술적 제약/단위 |
글자 수·단어 단위에 따른 토큰 수 (API 과금 기준) |
컨텍스트 윈도우 (최대 참조 토큰 수 한도) |
| 주요 영향력 |
입출력 속도, 연산 메모리 요구량, API 비용 |
복합 추론 능력, 이전 대화 기억 유지, 환각 억제력 |
4. 토큰과 컨텍스트가 실무에서 중요한 이유
- API 비용과 추론 속도의 기준: 클라우드 LLM 서비스의 요금은 입력 토큰과 출력 토큰의 총량을 기준으로 부과되며, 토큰 수가 많아질수록 연산 시간과 VRAM 소모량이 증가합니다.
- 맥락 상실 및 환각 방지: 대화가 길어져 컨텍스트 윈도우 한도를 넘어서면 이전 내용을 잊어버리거나 사실과 다른 엉뚱한 답변을 생성하는 환각(Hallucination) 현상이 발생하기 쉽습니다.
- 검색 증강 생성(RAG) 연동: 최신 문서나 사내 규정을 벡터 DB에서 검색하여 프롬프트 컨텍스트에 주입해 주면, 모델은 해당 문맥을 바탕으로 정확한 사실 기반 답변과 출처를 제시할 수 있습니다.
결론
토큰이 LLM이라는 언어 엔진을 움직이는 최소의 데이터 연료라면, 컨텍스트는 그 데이터들이 유기적으로 결합되어 형성하는 의미와 맥락의 지도입니다. 입력 텍스트가 어떻게 토큰화되고 컨텍스트 윈도우 안에서 어떻게 연산되는지 이해하는 것은 고품질 프롬프트를 작성하고 효율적인 AI 서비스를 구축하는 첫걸음입니다.

댓글목록
등록된 댓글이 없습니다.