Parameter(매개변수)가 LLM에 미치는 영향 총정리: 지식 용량부터 연산 비용까지
거대언어모델(LLM)의 성능과 기술 사양을 논할 때 가장 먼저 확인하는 지표는 바로 파라미터(Parameter, 매개변수)의 규모입니다. 파라미터는 인공신경망의 가중치 총합으로 모델의 지식과 논리 추론 패턴이 저장되는 두뇌 역할을 담당합니다. 파라미터 규모가 모델의 언어 이해력, 창발적 문제 해결 능력, 그리고 하드웨어 연산 자원에 미치는 핵심 영향을 체계적으로 정리합니다.
[Flowchart] 파라미터 규모에 따른 LLM 역량과 자원 변화
[파라미터 확장 (수억 단위 ➔ 수천억 B)] ➔ [지식 저장 용량(Parametric Memory) 및 문맥 이해 확대] ➔ [창발적 다단계 논리 추론 발현] ➔ [VRAM·연산 전력·지연 시간 동시 증가] ➔ [양자화 및 SLM 최적화 전략 필요]
파라미터 규모 확장에 따른 지능 향상과 하드웨어 트레이드오프 구조[cite: 4, 6, 8, 10]
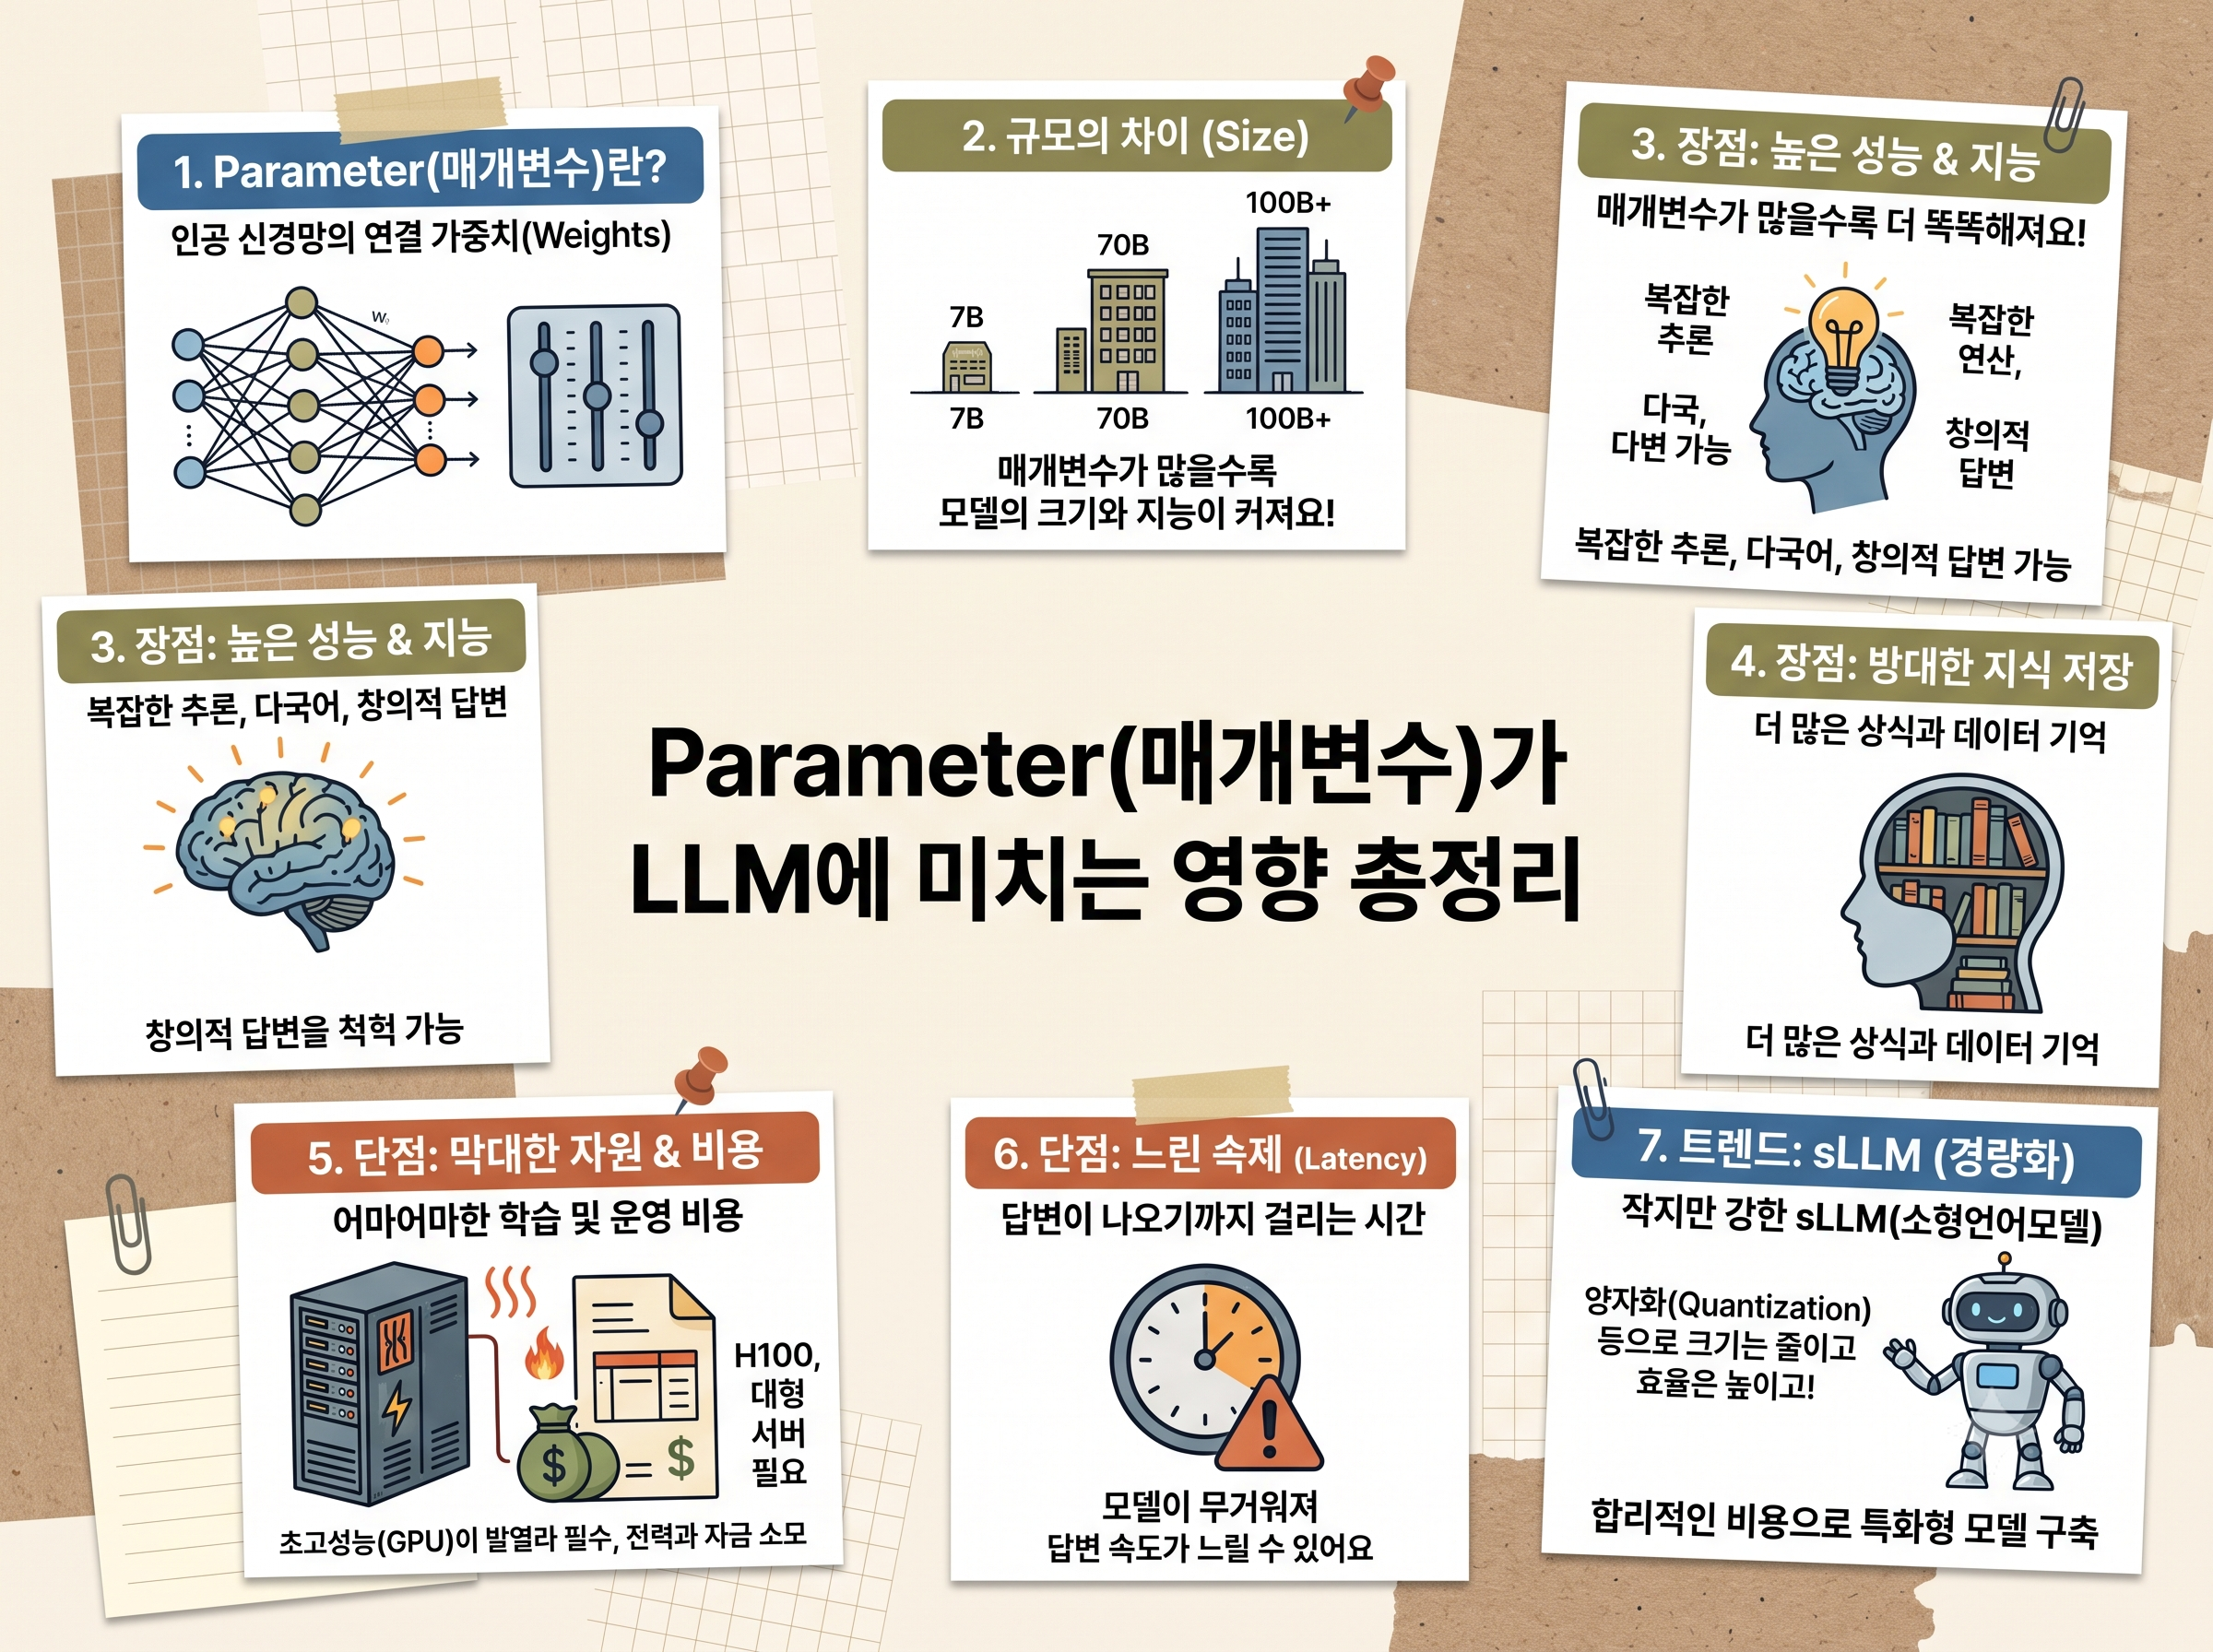
1. LLM에서 파라미터(Parameter)란 무엇인가?
파라미터는 모델이 방대한 비정형 텍스트를 학습하며 축적한 연결 가중치(Weights)의 총합을 의미합니다.
- 두뇌의 시냅스 역할: 인간 뇌의 시냅스 연결 강도처럼, 입력된 단어들 사이의 관계를 계산하고 다음 단어를 예측할 때 각 신경망 노드가 부여하는 수학적 가중치입니다.
- 규모 표기 단위: 일반적으로 10억 단위를 뜻하는 'B(Billion)'로 표기하며, 과거 수백만~수억 개 단위의 전용 NLP 모델에서 현대 LLM은 수십억(B)에서 수천억 개 단위 이상으로 확장되었습니다.
- 사실적 지식의 저장소: 트랜스포머 아키텍처의 피드포워드 신경망(FFN) 등에 결합되어 언어 모델 내부의 사실적 지식(Parametric Memory)을 보관하고 인출하는 기반이 됩니다.
2. 파라미터 규모가 LLM에 미치는 3가지 핵심 영향
1) 지식 저장 용량 및 언어 이해력의 비약적 확장
파라미터 수가 증가할수록 신경망이 담아낼 수 있는 정보의 밀도와 복잡도가 높아집니다.
- 정밀한 문맥 파악: 방대한 말뭉치 속 단어 간 상관관계를 다차원 벡터 공간상에 더 촘촘하게 배치함으로써 다의어의 모호성을 해결하고 복잡한 장문 맥락을 매끄럽게 처리합니다.
- 광범위한 배경지식 내재화: 사전 학습 과정에서 접한 다국어 어휘, 문법 구조, 과학적 상식, 전문 도메인 지식을 내부 가중치에 더 많이 축적할 수 있습니다.
2) 창발적 능력(Emergent Abilities)과 복합 추론의 발현
파라미터 규모가 일정 임계점을 넘어서면, 기존 소형 모델에서는 나타나지 않던 고도화된 지적 능력이 자발적으로 발현됩니다.
- 다단계 논리 유추: 단순히 다음 단어를 통계적으로 잇는 수준을 넘어 복합적인 다단계 추론과 수학적 알고리즘 연산을 자율적으로 풀어냅니다.
- 코드 생성 및 디버깅: 프로그래밍 언어의 문법 구조와 논리 흐름을 이해하고 스스로 에러를 찾아 수정하는 역량이 대형 모델에서 비약적으로 향상됩니다.
3) 하드웨어 인프라 요구량 및 연산 비용 증가 (트레이드오프)
파라미터의 증가는 지능의 향상을 가져오지만, 운영 인프라 측면에서는 명확한 물리적 한계를 수반합니다.
- 고용량 VRAM 요구: 수십억~수천억 개의 가중치를 GPU 메모리에 적재해야 하므로 고가의 서버용 GPU 클러스터가 필수적입니다.
- 추론 지연 시간(Latency) 및 전력 소모: 매 토큰을 생성할 때마다 거대한 신경망 레이어를 거쳐야 하므로 연산 시간이 길어지고 실시간 서비스 적용 시 비용 부담이 가중됩니다.
3. 파라미터 규모별 언어 모델 특성 비교
| 구분 |
초경량 / 소형 (0.5B ~ 9B, SLM) |
중형 (14B ~ 32B) |
대형 (70B 이상 및 초대형 MoE) |
| 주요 특징 |
최소 하드웨어 구동, 특정 단일 과업 최적화 |
다국어 이해 및 비즈니스 처리 밸런스 우수 |
창발적 다단계 논리 추론, 상용급 코딩 능력 |
| 연산 인프라 요구치 |
일반 노트북 RAM 또는 보급형 단일 GPU (8GB 이하) |
중급 GPU (16GB~24GB VRAM) 수준 |
고성능 멀티 GPU 클러스터 필수 |
| 권장 작업 영역 |
온디바이스 비서, 텍스트 분류, 단순 요약 |
한국어 RAG 시스템 구축, 사내 문서 질의응답 |
고난도 코딩 디버깅, 수학 연산, 복합 전략 수립 |
| 대표 모델 라인업 |
Microsoft Phi, Google Gemma |
Alibaba Qwen, Meta Llama (중형 라인) |
Meta Llama 70B, DeepSeek MoE 시리즈 |
4. 파라미터 한계를 극복하는 3대 실무 전략
- 양자화(Quantization) 기술: 16비트 모델 가중치를 4비트(Q4)나 8비트(Q8) 정수형으로 압축하여 모델 크기와 VRAM 사용량을 획기적으로 절감합니다.
- 플랫폼 맞춤형 로컬 포맷(GGUF / MLX): Windows와 Linux에서는 CPU/GPU 분할 오프로딩을 지원하는
GGUF를 사용하고, Mac에서는 통합 메모리 대역폭을 살리는 MLX를 활용해 중소형 모델의 실행 효율을 극대화합니다.
- RAG(검색 증강 생성) 연동: 최신 지식을 담기 위해 모델 파라미터를 무작정 늘리는 대신, 외부 벡터 DB에서 문서를 검색해 프롬프트 문맥에 제공함으로써 작은 모델로도 정확한 출처 기반 답변을 얻어냅니다.
결론
파라미터는 LLM의 지적 용량과 창발적 추론을 견인하는 핵심 엔진이지만, 무조건 파라미터가 큰 모델이 최선의 해답은 아닙니다. 해결하려는 과업의 복잡도와 하드웨어 인프라 예산을 종합적으로 고려하여 최적 크기의 모델을 선택하고 양자화 및 RAG 기술을 결합하는 것이 가장 성공적인 실무 AI 구축 전략입니다.

댓글목록
등록된 댓글이 없습니다.