트랜스포머(Transformer)란 무엇인가? 현대 생성형 AI를 만든 핵심 아키텍처
현대 생성형 AI와 거대언어모델(LLM)의 폭발적 성장을 이끈 기술적 백본은 바로 트랜스포머(Transformer)입니다. 2017년 구글의 논문 "Attention Is All You Need"를 통해 처음 공개된 이후, 기존 순환 신경망(RNN) 기반의 한계를 극복하고 자연어 처리(NLP)를 넘어 컴퓨터 비전, 오디오 등 AI 전 영역의 표준 아키텍처로 자리 잡았습니다.
트랜스포머의 핵심 개념과 동작 원리, 기존 모델과의 구조적 차이점을 일목요연하게 정리합니다.
[Flowchart] 트랜스포머의 데이터 처리 흐름
[자연어 텍스트] ➔ [토큰화 & 임베딩] ➔ [위치 인코딩(Positional Encoding)] ➔ [멀티 헤드 셀프 어텐션(Self-Attention)] ➔ [피드포워드 신경망(FFN)] ➔ [출력 확률 예측]
원시 텍스트가 병렬 어텐션 블록을 통과해 출력 확률로 변환되는 과정
1. 트랜스포머의 본질: '순차적 처리'에서 '동시 병렬 처리'로
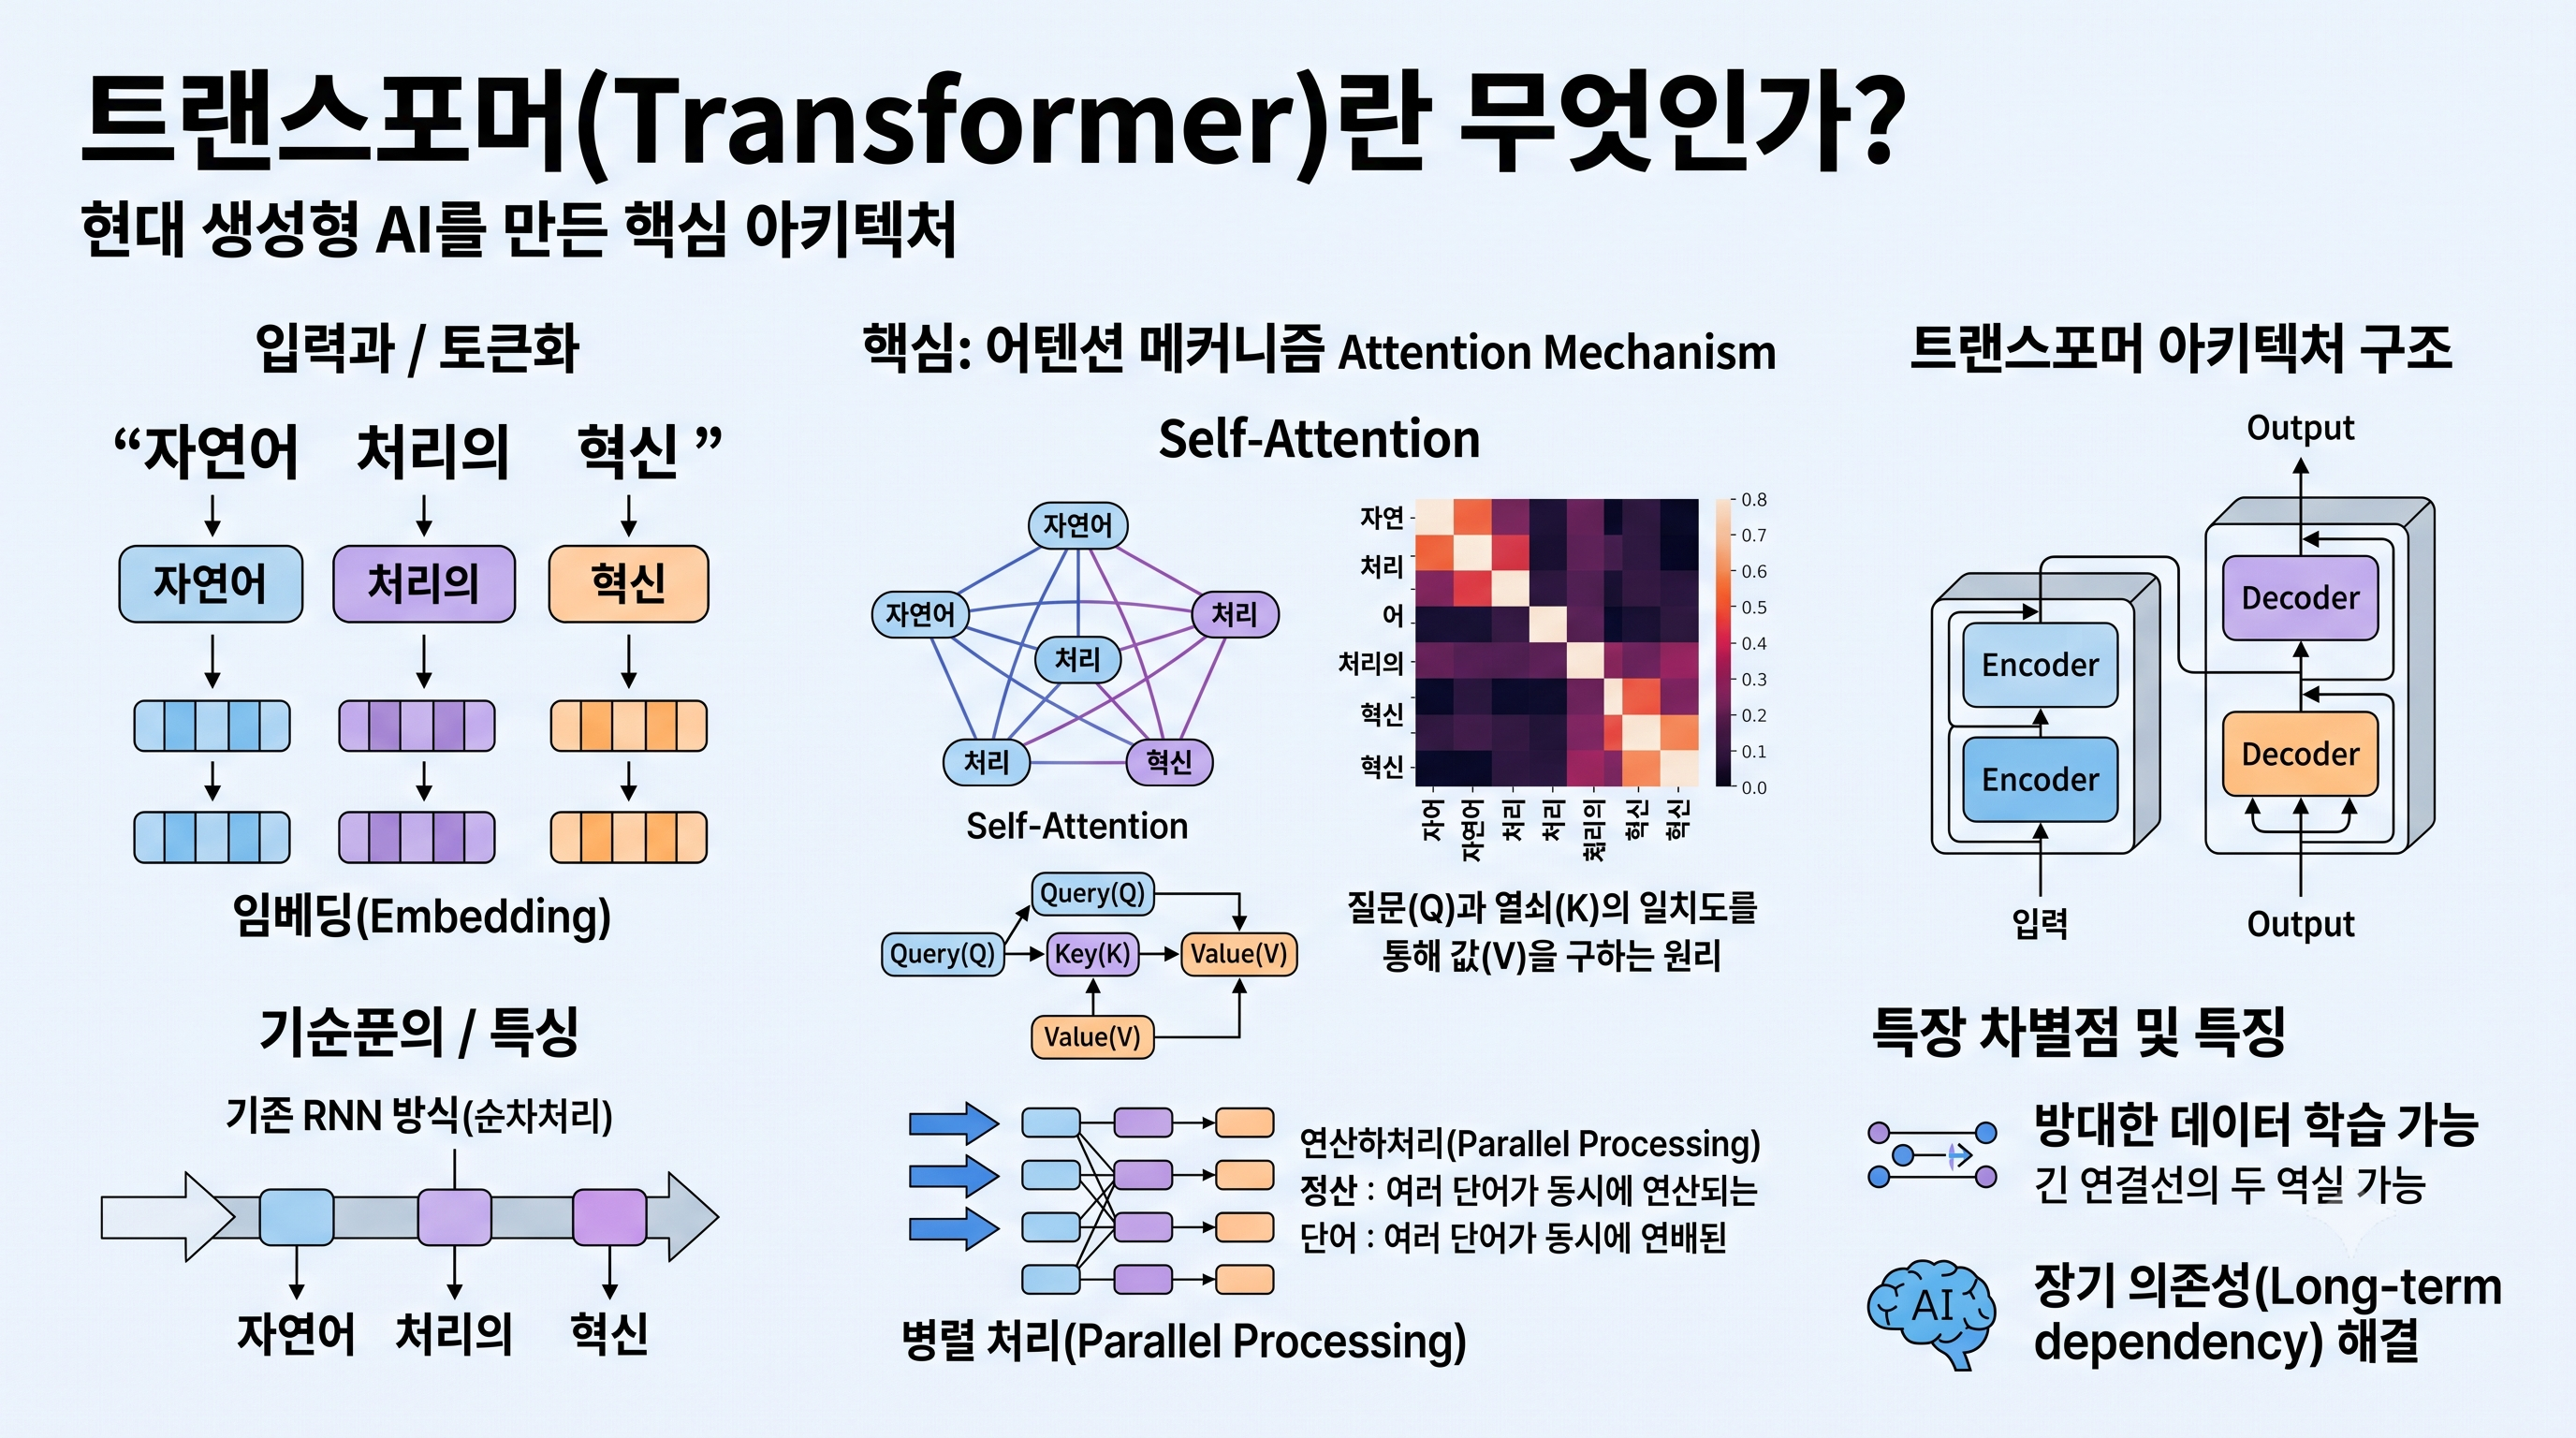
기존 시퀀스 모델(RNN, LSTM)은 문장의 단어를 순서대로 하나씩 읽어 들여 연산했습니다. 이로 인해 문장이 길어질수록 앞쪽 정보가 희석되는 장기 의존성(Long-term Dependency) 문제와 GPU 병렬 연산이 불가능해 학습 속도가 느리다는 치명적인 단점이 있었습니다.
트랜스포머는 이러한 구조를 탈피하여 문장 전체를 한 번에 입력받고 단어 간의 연관성을 통째로 파악하는 혁신적인 설계를 적용했습니다.
2. 트랜스포머를 지탱하는 4대 핵심 구성 요소
- 위치 인코딩 (Positional Encoding): 문장 내 단어들을 동시에 병렬로 입력받기 때문에 사라질 수 있는 단어의 순서(어순) 정보를 삼각함수(Sin/Cos) 기반 벡터 값으로 임베딩 벡터에 더해줍니다.
- 셀프 어텐션 (Self-Attention): 문장 속 각 단어가 서로에게 미치는 영향력(주목도 가중치)을 직접 계산합니다. 문맥 안에서 대명사가 무엇을 가리키는지, 다의어가 어떤 의미로 쓰였는지 명확히 파악합니다.
- 피드포워드 신경망 (Feed-Forward Network, FFN): 어텐션 블록이 추출한 문맥 관계 정보를 각 토큰 위치별로 독립적인 비선형 변환을 거쳐 모델 내부 파라미터 지식으로 축적합니다.
- 잔차 연결 및 정규화 (Add & Norm): 신경망 레이어가 수십~수백 겹으로 깊어져도 그래디언트 소실(Vanishing Gradient) 없이 학습 신호가 안정적으로 흐르도록 보장합니다.
3. Query, Key, Value(Q·K·V) 메커니즘 한눈에 보기
셀프 어텐션은 검색 엔진의 질의·응답 방식과 유사한 Q·K·V 연산으로 작동합니다.
- Query (질의): 현재 분석 대상이 되는 기준 단어
- Key (키값): 문맥 내 모든 대상 단어의 고유 식별 주소
- Value (내용값): 각 단어가 지닌 실제 의미 정보의 벡터
Query와 Key의 내적을 계산하여 상호 유사도(어텐션 스코어)를 구하고, 이를 가중치 삼아 Value 벡터를 가중합함으로써 문맥이 완전히 반영된 새로운 단어 벡터를 생성합니다.
4. 기존 순환 신경망(RNN) vs 트랜스포머 비교
| 비교 항목 |
전통적 시퀀스 모델 (RNN / LSTM) |
트랜스포머 (Transformer) |
| 처리 방식 |
단어를 순차적으로 하나씩 처리 (Sequential) |
문장 내 모든 단어를 일괄 병렬 처리 (Parallel) |
| 연산 속도 |
GPU 병렬 처리 제약으로 대규모 학습 한계 |
뛰어난 병렬화로 대규모 고속 연산 가능 |
| 장기 기억력 |
거리가 멀어질수록 정보 손실 및 왜곡 발생 |
토큰 간 거리에 관계없이 문맥 전체를 균등 참조 |
| 핵심 기법 |
히든 스테이트(Hidden State) 순환 누적 |
셀프 어텐션(Self-Attention) 가중합 연산 |
| 모델 확장성 |
파라미터 대형화가 사실상 불가능 |
수십억~수천억 파라미터(LLM)로 무한 확장 가능 |
5. 트랜스포머 기반의 3가지 모델 계열
- 인코더 전용 모델 (예: BERT): 문맥 전체를 양방향으로 깊이 이해하는 데 특화되어 문서 분류, 문장 유사도 분석, 개체명 인식에 주로 사용됩니다.
- 디코더 전용 모델 (예: GPT 계열, Llama): 앞서 나온 단어를 기반으로 다음 단어를 연속 생성(Autoregressive)하는 텍스트 생성 작업에 탁월합니다.
- 인코더-디코더 복합 모델 (예: T5, 초기 번역기): 입력을 완전히 해석한 후 새로운 언어로 재구성하는 번역 및 장문 요약에 적합합니다.
결론
트랜스포머는 모든 단어 간의 상호 작용을 병렬 행렬 연산으로 일괄 처리하는 독창적인 구조를 통해 기존 언어 모델의 한계를 극복했습니다. 오늘날 GPT, Gemini, Claude 등 세상을 뒤흔들고 있는 모든 거대언어모델의 지능은 바로 이 트랜스포머 아키텍처 위에 구축되어 있습니다.

댓글목록
등록된 댓글이 없습니다.