LLM Pretraining과 Inference의 차이: 지식의 구축 vs 지식의 인출
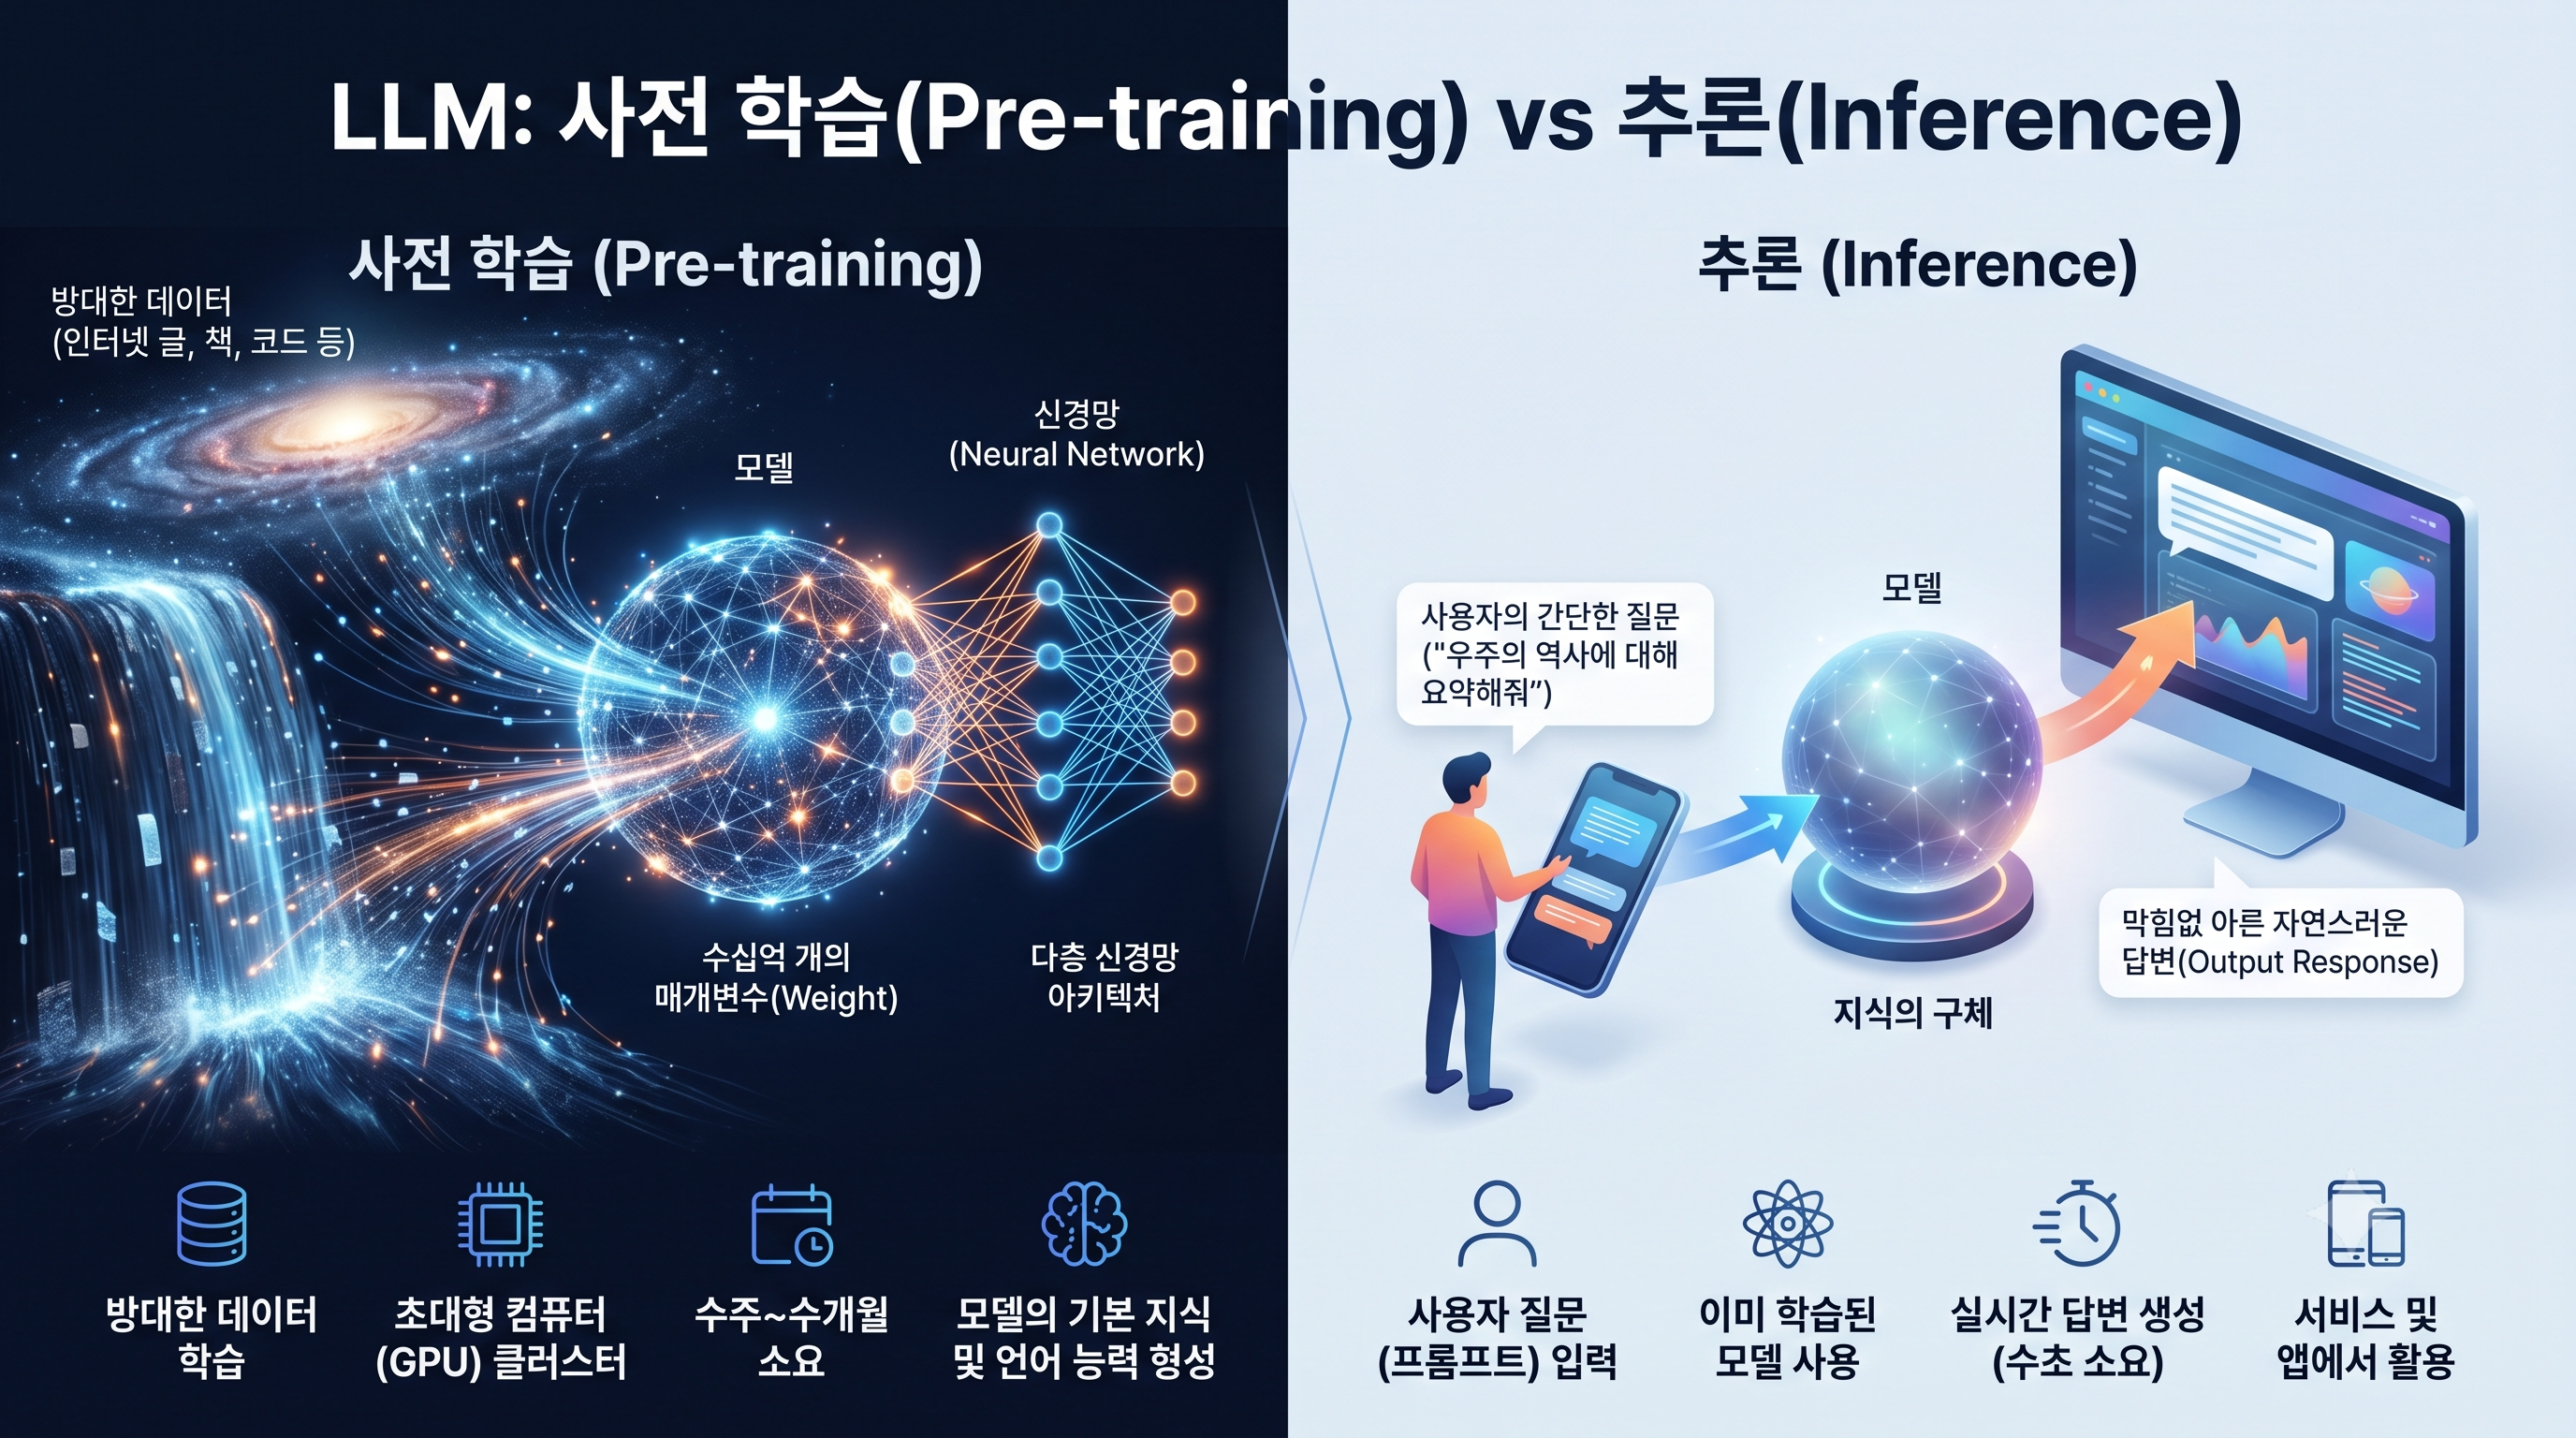
거대언어모델(LLM)을 효과적으로 이해하고 비즈니스에 적용하기 위한 가장 핵심적인 두 기둥은 바로 사전 학습(Pre-training)과 추론(Inference)입니다. 두 단계는 연산의 목적, 데이터 처리 흐름, 시스템 자원 소모 방식에서 명확히 구분됩니다.
모델이 방대한 언어와 지식을 스스로 학습하여 뇌를 형성하는 과정과, 사용자의 요청을 받아 이를 실시간으로 꺼내어 답하는 실행 과정의 차이를 구조적으로 정리합니다.
[Flowchart] LLM 라이프사이클 처리 구조
- 사전 학습(Pre-training): [웹 규모 말뭉치] ➔ [순전파 및 역전파] ➔ [가중치(파라미터) 대규모 갱신]
- 추론(Inference): [사용자 프롬프트] ➔ [동결된 가중치 기반 순전파] ➔ [자기회귀적 다음 토큰 순차 생성]
가중치를 새롭게 학습하는 단계와 고정된 가중치로 결과를 계산하는 단계의 차이
1. 사전 학습(Pre-training): 기초 지식의 내재화
사전 학습은 모델이 아무런 사전 지식이 없는 백지상태에서 언어의 문법, 논리 구조, 세상에 대한 보편적 지식을 학습하여 기초 모델(Foundation Model)을 만드는 초기 단계입니다.
- 자기지도학습(Self-supervised Learning): 수작업 라벨링 없이 대규모 웹 텍스트에서 다음에 올 단어를 맞추는 방식으로 언어적 규칙을 체화합니다.
- 양방향 연산: 다음 단어를 예측하는 순전파(Forward Pass) 후 오차를 계산하고, 역전파(Backpropagation)를 통해 수십억~수천억 개의 파라미터를 대규모로 업데이트합니다.
- 막대한 인프라 비용: 수천 대 이상의 고성능 GPU 클러스터가 수주에서 수개월 동안 지속적으로 연산을 수행해야 합니다.
2. 추론(Inference): 실시간 답변 연산 및 출력
추론은 이미 학습과 정렬을 마친 모델에 프롬프트를 전달했을 때, 실시간으로 적절한 답변 토큰을 계산하여 출력하는 실행 단계입니다.
- 가중치 동결(Frozen Weights): 추론 도중에는 모델 파라미터가 변경되지 않으며, 학습 완료된 고정 가중치를 오직 읽기 전용으로만 참조합니다.
- 순전파 전용 연산: 역전파나 오차 수정 과정 없이, 입력 문맥을 기반으로 다음 토큰의 확률 분포를 계산하는 단방향 순전파만 수행합니다.
- 자기회귀(Autoregressive) 생성: 직전에 생성된 토큰을 다시 새로운 입력에 누적하며 종료 토큰(EOS)이 나올 때까지 하나씩 순차적으로 이어 붙입니다.
- 디코딩 제어: 사용자의 목적에 맞게 Temperature나 Top-p 값을 조절하여 답변의 창의성과 결정성을 제어합니다.
3. Pre-training vs Inference 핵심 비교
| 비교 항목 |
사전 학습 (Pre-training) |
추론 (Inference / Generation) |
| 주요 목적 |
보편적 언어 패턴 및 일반 지식 습득 |
사용자 프롬프트에 대한 실시간 답변 생성 |
| 가중치 상태 |
역전파를 통해 지속적으로 갱신 및 수정 |
수정 없이 읽기 전용으로 동결(Frozen) |
| 연산 방향 |
순전파(Forward) + 역전파(Backward) |
순전파(Forward Pass) 단방향 연산 |
| 데이터 처리 |
대규모 텍스트 배치를 대규모 병렬 처리 |
단어(토큰)를 하나씩 생성하는 자기회귀 순차 처리 |
| 하드웨어 요구량 |
대규모 멀티 GPU 클러스터 필수 |
단일/소규모 GPU, 클라우드 API, 경량 로컬 환경 |
| 주요 최적화 기법 |
분산 병렬 학습, 혼합 정밀도(FP16/BF16) |
KV 캐싱, 양자화(INT8/INT4), 디코딩 샘플링 |
4. 실무 관점에서의 시사점
초기 기초 모델을 백지에서 만드는 사전 학습은 소수의 빅테크 및 최상위 AI 연구 기관의 영역입니다. 반면 대다수 기업과 실무 엔지니어링의 핵심은 사전 학습된 모델을 어떻게 효율적으로 서빙하고 비용을 절감하며 추론할 것인가에 집중됩니다.
- 지연 시간(Latency) 및 VRAM 최적화: 실시간 사용자 경험을 확보하기 위해 토큰당 생성 속도를 최적화하고 KV 캐싱 및 모델 양자화(Quantization)를 적극 도입합니다.
- 최신 지식 공백 해결: 사전 학습 완료 시점에 모델 지식이 고정되는 한계를 극복하기 위해, 추론 단계에서 외부 벡터 DB를 연동하는 RAG(검색 증강 생성) 기법을 함께 운용합니다.

결론
사전 학습이 인간에 비유하자면 수년에 걸쳐 방대한 서적을 탐독해 두뇌 지식을 쌓는 과정이라면, 추론은 시험장에서 주어진 문제를 보고 축적된 기억을 꺼내어 답안지를 작성하는 실전 과정입니다. 두 연산의 특성을 구분하여 이해하면 LLM 애플리케이션의 개발 및 인프라 설계 방향을 명확하게 설정할 수 있습니다.

댓글목록
등록된 댓글이 없습니다.