LLM의 추론(Inference) 과정 이해하기: 프롬프트 입력부터 답변 완성까지
거대언어모델(LLM)은 정답을 검색해 복사하는 시스템이 아니라, 문맥을 벡터로 압축하고 실시간 확률 계산을 통해 다음 토큰을 순차 생성하는 통계적 연산 엔진입니다.
사전 학습(Pre-training)과 달리 가중치 동결 상태에서 단방향 순전파(Forward Pass)만을 거쳐 답변을 도출하는 4단계 파이프라인과 실무 최적화 기법을 체계적으로 살펴봅니다.
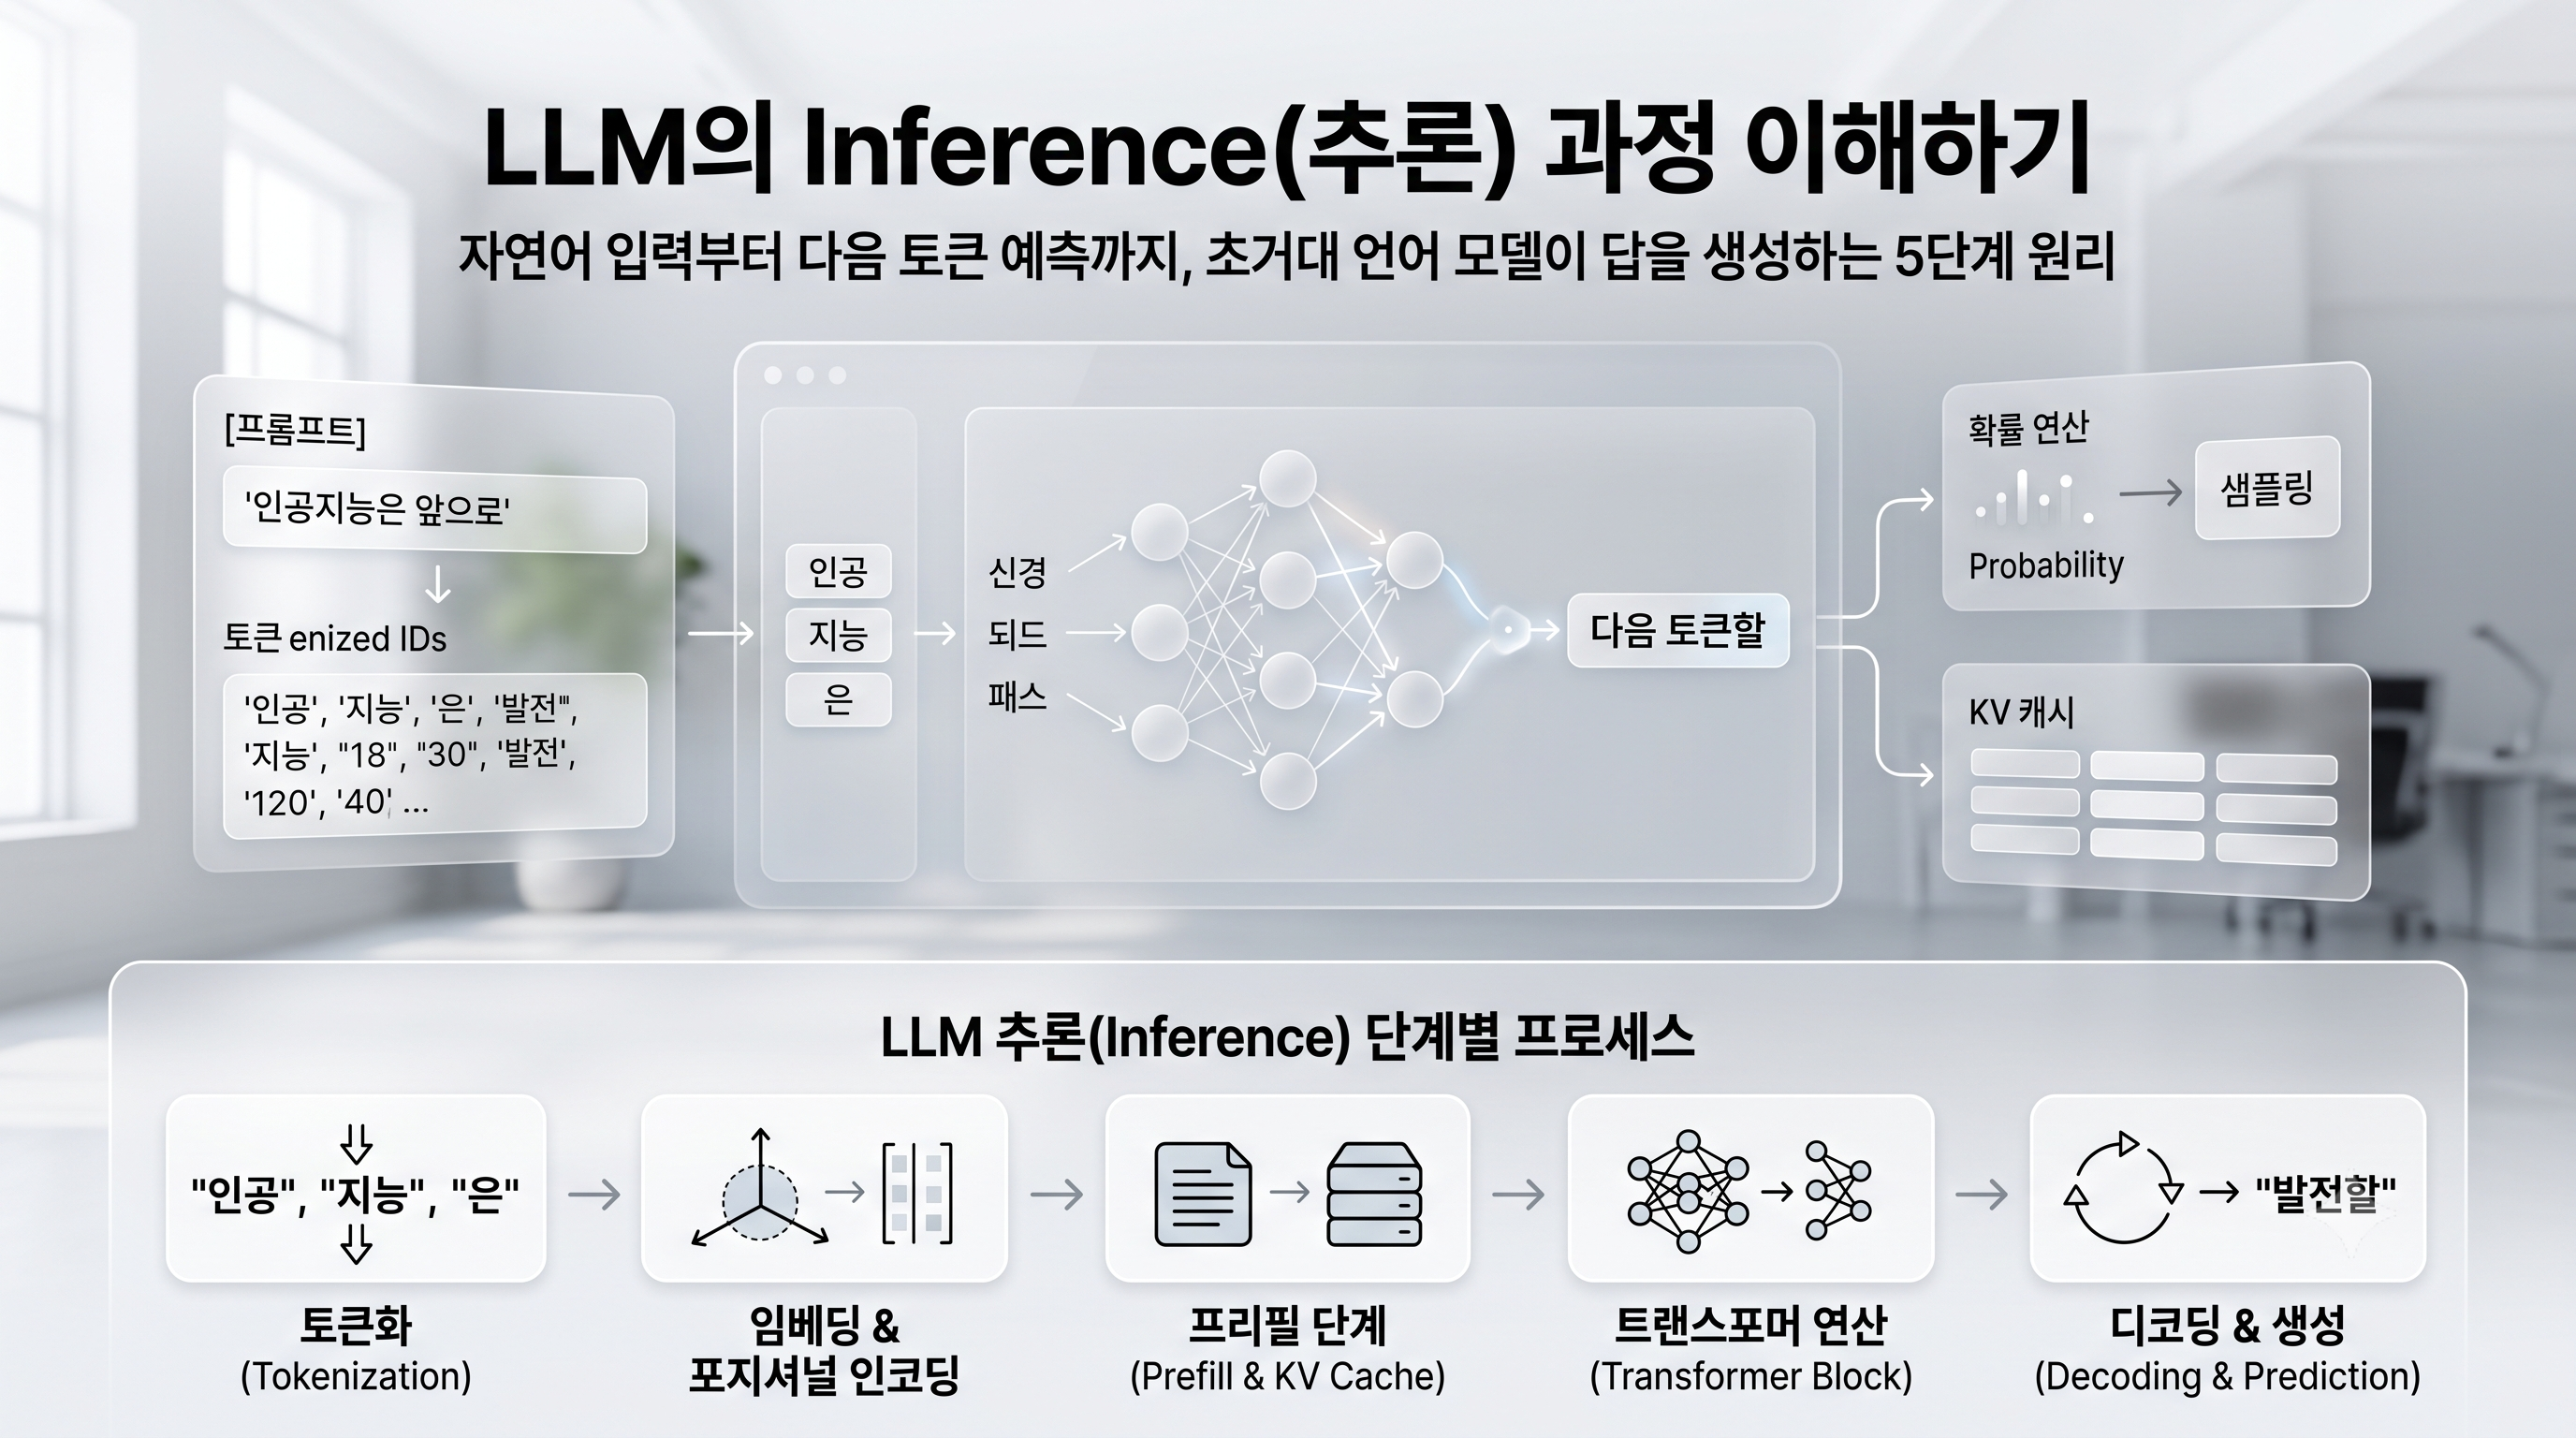
[Flowchart: LLM 추론 파이프라인]
입력 프롬프트 ➔ 1. 토큰화 및 임베딩 ➔ 2. 셀프 어텐션 기반 문맥 압축 ➔ 3. Softmax 확률 분포 계산 ➔ 4. 자기회귀(Autoregressive) 생성 루프 ➔ 최종 답변 출력
가중치 동결 상태에서 순전파 연산으로 토큰을 연속 생성하는 전체 추론 구조
1. LLM 추론의 4단계 실행 파이프라인
자연어는 다차원 수치 벡터로 변환된 후 트랜스포머의 어텐션 메커니즘을 거쳐 가장 확률이 높은 다음 토큰을 연속적으로 출력합니다.
- 토큰화(Tokenization) 및 임베딩(Embedding): 자연어 문장을 최소 의미 단위인 토큰(Token)으로 분할하고 고유 정수 ID를 부여합니다. 각 토큰은 다차원 벡터 공간의 의미 좌표로 매핑되며, 병렬 처리로 인한 순서 소실을 막기 위해
Positional Encoding이 합성됩니다.
- 셀프 어텐션(Self-Attention) 기반 문맥 압축: 문장 내 모든 토큰 간의 상관관계와 주목도 가중치(Attention Weight)를 계산합니다. 다의어의 모호성을 해소하고 대명사가 지칭하는 대상을 특정하여 프롬프트 전체 맥락을 하나의 문맥 벡터로 집약합니다.
- 다음 토큰 확률 분포 계산 (Softmax): 모델의 출력단(LM Head)은 사전 학습된 어휘 사전(Vocabulary) 내 수만~수십만 개 후보 토큰을 대상으로 다음에 등장할 조건부 확률 분포를 계산합니다.
- 자기회귀(Autoregressive) 생성 반복: 선택된 토큰을 기존 입력 끝에 누적한 후 다시 다음 토큰을 예측하는 루프를 수행합니다. 이 과정은 문장의 마침표나
EOS(End of Sequence) 토큰이 도출될 때까지 반복됩니다.
Note: 추론 단계에서는 역전파(Backpropagation)가 발생하지 않으며, 오직 순방향 연산(Forward Pass)만을 거쳐 실시간 토큰을 산출합니다.
2. 사전 학습(Pre-training)과 추론(Inference)의 기술적 대조
추론은 모델 파라미터를 갱신하지 않고 이미 확정된 지식을 읽기 전용으로 인출하는 단방향 실행 단계입니다.
| 비교 항목 |
사전 학습 (Pre-training) |
추론 (Inference) |
| 연산 목적 |
보편적 언어 패턴 및 배경 지식 내재화 |
사용자 질의에 대한 실시간 응답 도출 |
| 가중치 상태 |
역전파를 통한 지속적 대규모 갱신 |
읽기 전용 동결 (Frozen Weights) |
| 연산 방향 |
순전파(Forward) 및 역전파(Backward) 병행 |
순전파(Forward Pass Only) 단방향 연산 |
| 데이터 처리 |
대규모 텍스트 배치 병렬 연산 |
단일 토큰 단위의 자기회귀 순차 생성 |
| 최적화 초점 |
분산 병렬 클러스터 효율화 |
지연 시간 단축 및 메모리(VRAM) 절감 |
3. 디코딩(Decoding) 파라미터 제어
확률 분포에서 단순히 1위 단어만 고르는 결정론적 선택을 지양하고 샘플링 파라미터를 통해 답변의 논리성과 다양성을 조율합니다.
주요 샘플링 파라미터 규격
- Temperature: 확률 분포 곡선의 평탄화 수준을 제어합니다.
temperature를 낮추면 결정론적이고 논리적인 답변이 출력되며, 높이면 무작위성이 증가하여 창의적인 단어가 선택됩니다.
- Top-p (Nucleus Sampling): 누적 확률 상위 p% 영역 내의 후보 토큰 군집만을 선택 범위로 유지합니다. 확률 꼬리(Long-tail)에 위치한 비논리적 이상 토큰 선택을 효과적으로 차단합니다.
- Top-k: 다음 토큰 후보군을 확률 순위 상위 k개로 엄격히 제한하여 생성 안정성을 보장합니다.

4. 실무 환경에서의 서빙 최적화 전략
대규모 파라미터를 안정적으로 운영하기 위해서는 연산 중복을 배제하고 메모리 병목 현상을 방어하는 엔지니어링 설계가 필수적입니다.
- KV 캐싱 (KV Caching): 매 스텝마다 누적되는 이전 토큰들의 Key, Value 연산 결과를 GPU 메모리에 캐싱하여 중복 계산을 배제합니다.
- 양자화 (Quantization): 16비트 부동소수점 가중치를 4비트 또는 8비트 정수형으로 변환해 VRAM 사용량을 대폭 낮추고
GGUF 및 MLX 기반 환경에서의 경량 실행을 지원합니다.
- RAG(검색 증강 생성) 연동: 사전 학습 시점 이후 발생하는 환각(Hallucination) 리스크와 최신 지식 공백을 해소하기 위해, 외부 벡터 DB에서 참조 문서를 검색하여 실시간 프롬프트에 주입합니다.
Note: 디코딩 시 메모리 대역폭(Memory Bandwidth)이 지연 시간(Latency)의 주된 병목이 되므로, KV 캐싱 크기 관리와 배치 최적화가 선행되어야 합니다.

댓글목록
등록된 댓글이 없습니다.