LLM에서 자주 사용하는 핵심 용어 총정리: 기본 원리부터 실무 배포까지
거대언어모델(LLM) 생태계는 방대한 텍스트 전처리, 트랜스포머 신경망 연산, 확률적 디코딩, 그리고 실무 경량화 기술이 유기적으로 맞물려 작동합니다.
입력 텍스트를 수치화하는 기초 개념부터 실무 서빙 단계의 핵심 제어 파라미터까지, LLM을 다룰 때 반드시 알아두어야 할 핵심 기술 용어를 5가지 영역으로 나누어 정리합니다.
[Flowchart: LLM 라이프사이클 및 핵심 기술 용어 맵]
텍스트 입력 ➔ 1. 토큰 & 임베딩 ➔ 2. 트랜스포머 & 파라미터 ➔ 3. 사전학습 & 정렬(RLHF) ➔ 4. 자기회귀 & 디코딩 제어 ➔ 5. RAG & 양자화(GGUF/MLX)
자연어 처리부터 추론 최적화까지 이어지는 핵심 용어 흐름
1. 텍스트 입력 및 전처리 관련 핵심 용어
인공지능은 자연어 문자열을 직접 계산할 수 없으므로 텍스트를 최소 단위로 분해하고 다차원 벡터 좌표로 매핑해야 합니다.
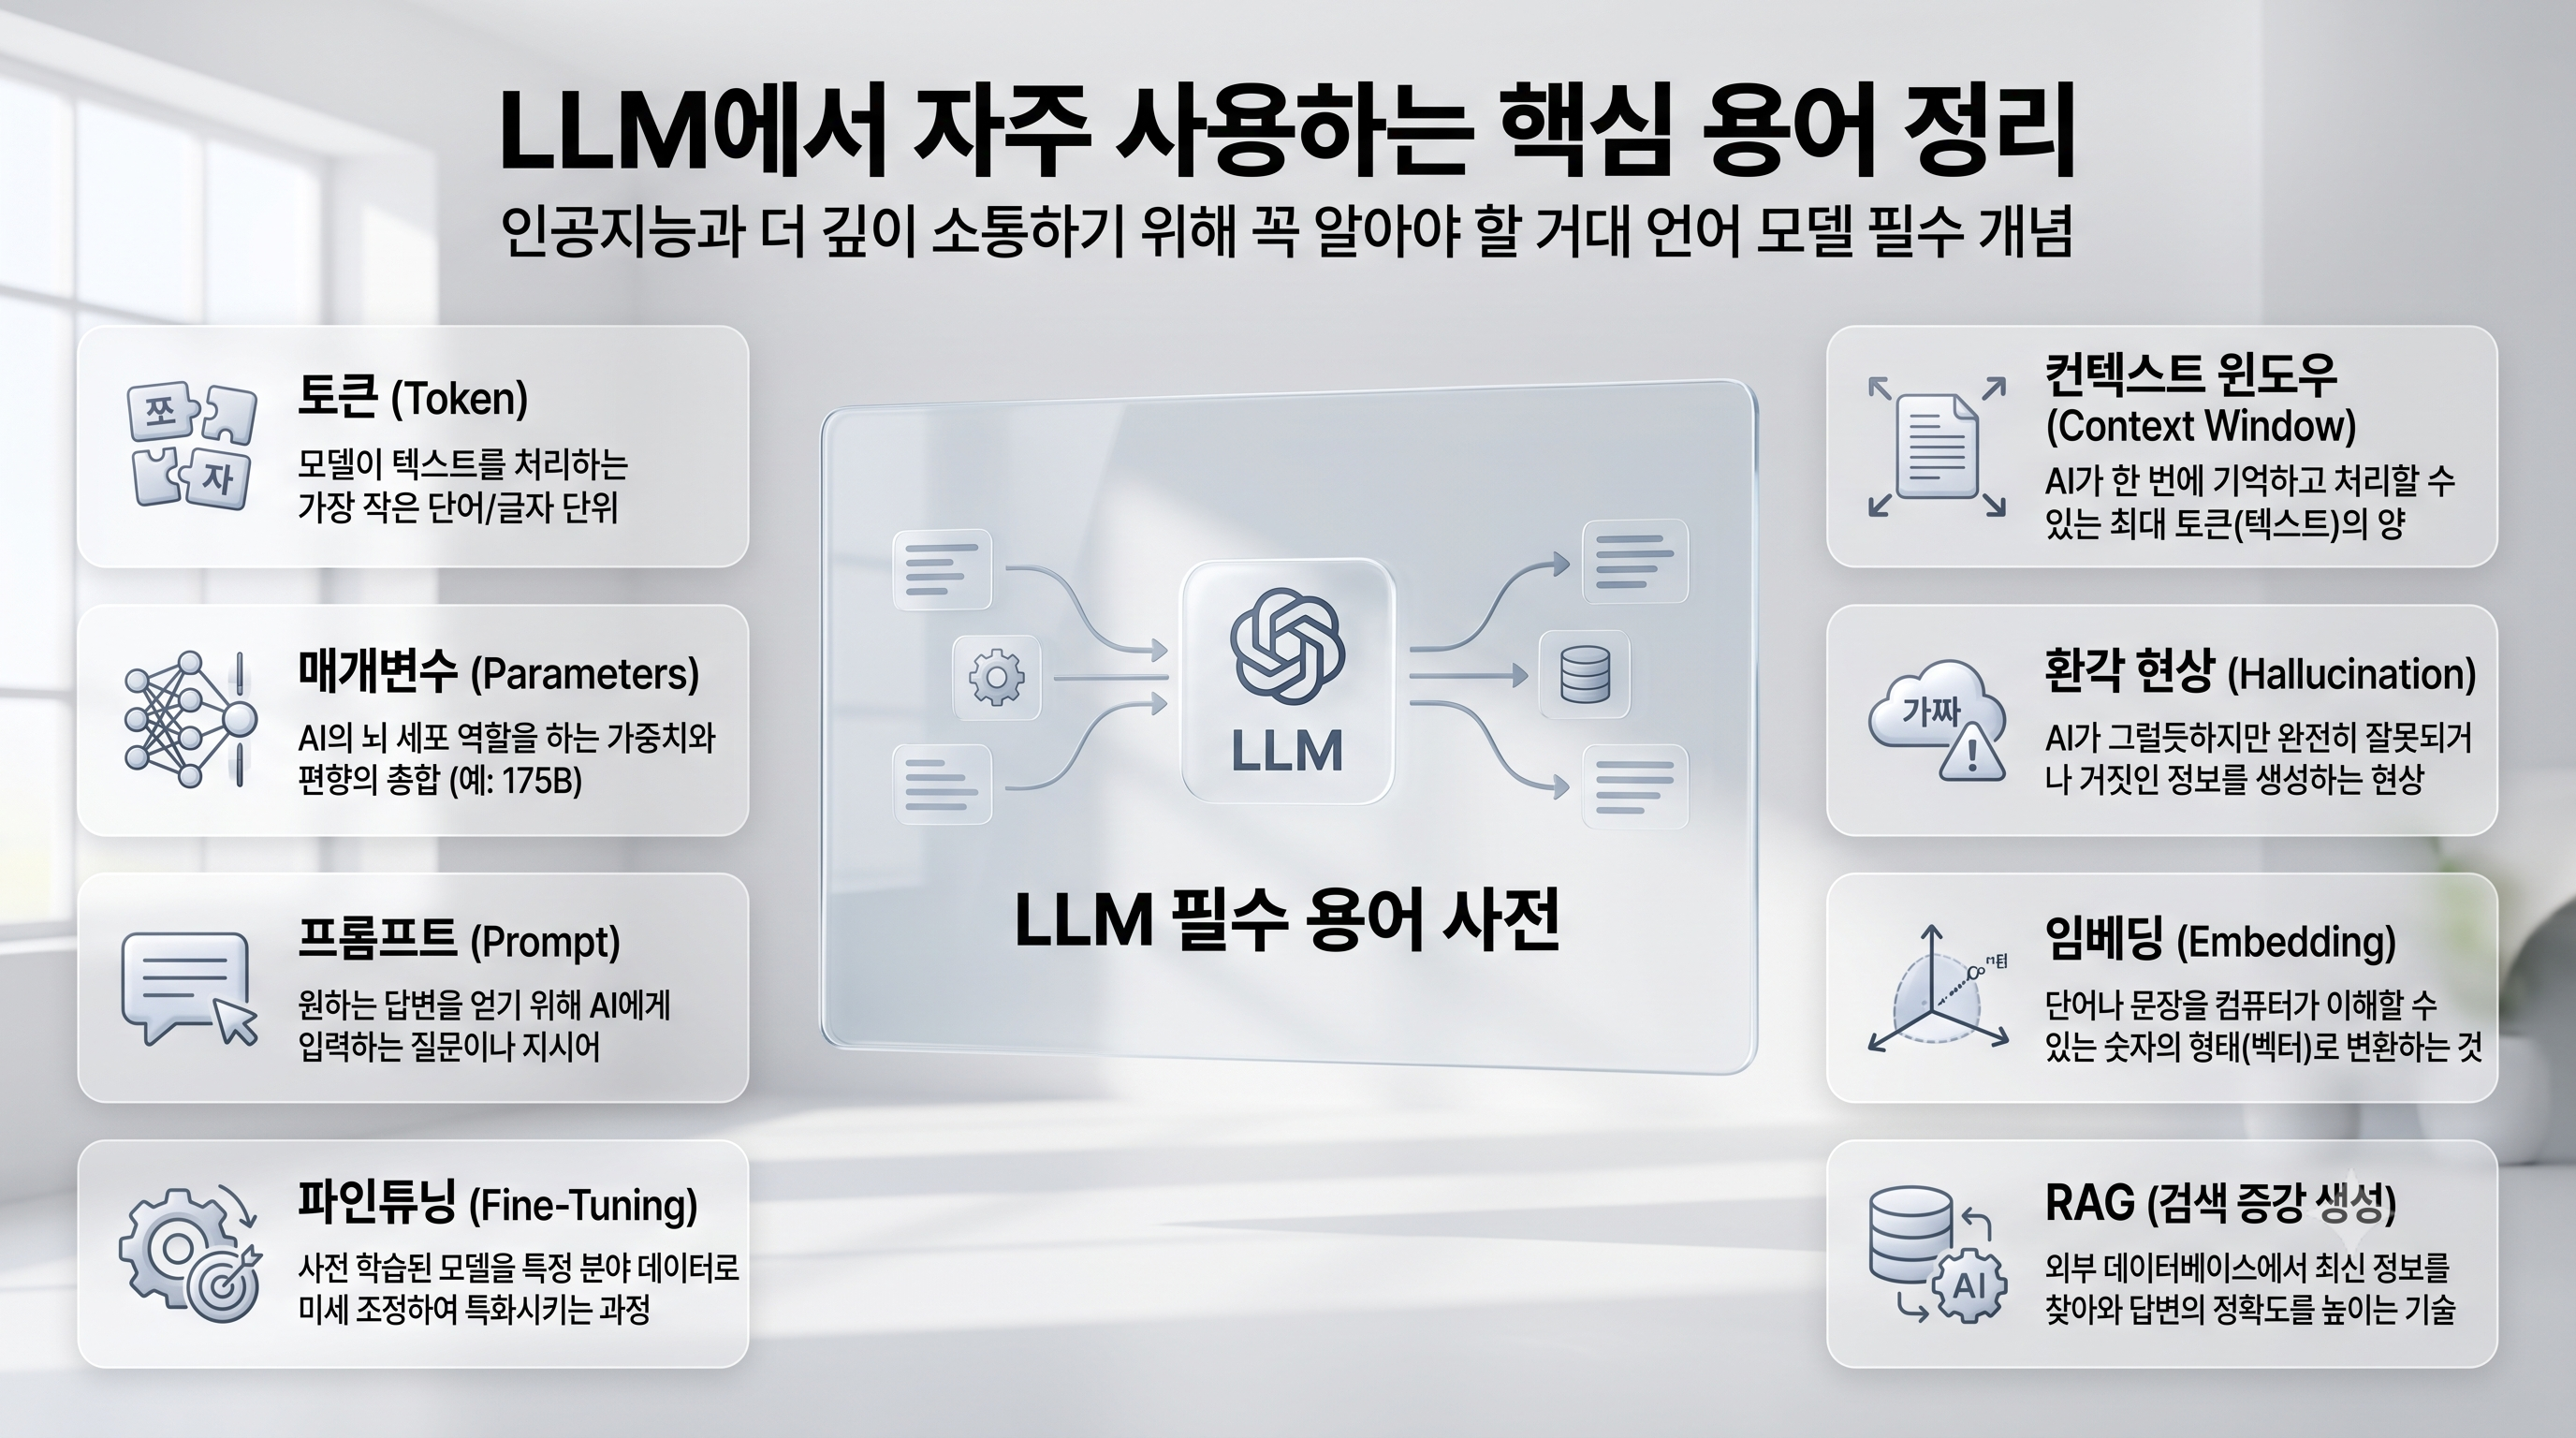
- 토큰(Token) & 토크나이저(Tokenizer): 모델이 처리할 수 있는 가장 작은 의미 단위의 텍스트 조각입니다. 토크나이저는 문장을 단어, 형태소, 서브워드(Subword) 단위로 분할하여 고유 정수 ID 번호로 변환합니다.
- 벡터 임베딩(Vector Embedding): 정수 ID로 변환된 토큰을 다차원 연속 벡터 공간의 좌표값으로 매핑하여 단어 간의 의미적 유사도를 수치화합니다.
- 위치 인코딩(Positional Encoding): 트랜스포머의 병렬 처리 구조에서 소실되기 쉬운 단어의 순서(어순) 정보를 벡터에 더해주는 기법입니다.
- 셀프 어텐션(Self-Attention): 문장 내 모든 토큰 간의 상관관계와 주목도 가중치(Attention Weight)를 계산하여 대명사 지칭 대상이나 다의어의 구체적 문맥을 파악하는 핵심 엔진입니다.
2. 모델 구조 및 규모 관련 핵심 용어
신경망의 가중치 규모와 참조 범위는 모델의 지식 저장량과 다단계 논리 추론 성능을 직접 결정합니다.
- 트랜스포머(Transformer): 셀프 어텐션 메커니즘을 기반으로 문맥 전체를 한 번에 병렬 처리하는 현대 LLM의 표준 인공신경망 백본 아키텍처입니다.
- 파라미터(Parameter, 매개변수): 대규모 텍스트를 학습하며 축적한 연결 가중치(Weights)의 총합으로, 모델의 지식과 논리 연산 패턴이 저장되는 척도입니다.
- 컨텍스트 윈도우(Context Window): 모델이 한 번의 추론 과정에서 동시에 기억하고 참조할 수 있는 최대 토큰 한도(입력 프롬프트와 생성 응답의 총합)입니다.
- 창발적 능력(Emergent Abilities): 모델 파라미터와 데이터 규모가 임계점을 넘어서면서, 사전 학습에서 명시적으로 훈련하지 않은 다단계 논리 추론, 코딩, 수학 연산 역량이 자발적으로 발현되는 현상입니다.
3. 학습 및 모델 제어 방식 비교
기초 모델을 구축하는 사전 학습과 인간의 선호도를 주입하는 정렬 단계는 역할과 연산 목적이 완전히 구분됩니다.
| 구분 |
개념 및 동작 방식 |
주요 목적 |
| 사전 학습 (Pre-training) |
라벨 없는 대규모 웹 말뭉치에서 다음 단어를 맞추는 자기지도학습 |
보편적 언어 문법 및 세상의 배경지식 습득 |
| 파인튜닝 (Fine-tuning / SFT) |
질문-답변 쌍 등 정제된 데이터셋을 통해 모델 가중치를 미세조정 |
특정 도메인 과업 수행력 부여 및 고유 어조 체화 |
| 정렬 (Alignment / RLHF) |
인간의 피드백을 기반으로 보상 모델을 적용해 안전성을 조율 |
유해 응답 차단 및 사용자 지시 준수율 극대화 |
4. 응답 생성 및 품질 제어 파라미터
자기회귀 루프에서 디코딩 파라미터를 조절하여 답변의 결정론적 정확도와 창의적 표현 간의 균형을 맞춥니다.
생성 및 디코딩 제어 규격
- 자기회귀(Autoregressive): 이전에 생성한 토큰을 다시 새로운 입력값으로 삼아
EOS(End of Sequence) 토큰이 도출될 때까지 다음 단어를 하나씩 순차 예측하는 생성 방식입니다.
- Temperature(온도): 다음 단어 확률 분포의 평탄화 정도를 조절합니다. 낮추면 논리적이고 결정론적인 답변이 도출되며, 높이면 무작위성이 증가해 다채로운 어휘가 선택됩니다.
- Top-p (Nucleus Sampling): 누적 확률 상위 p% 영역 내의 후보군에서만 단어를 선택하여 문맥에서 벗어난 엉뚱한 이상 단어 출력을 방어합니다.
- 환각(Hallucination): 모델이 학습하지 않은 사실이나 왜곡된 정보를 사실인 것처럼 그럴듯하게 날조하여 출력하는 통계적 언어 모델의 구조적 한계입니다.
5. 실무 최적화 및 로컬 배포 기술
환각 현상을 억제하고 고성능 GPU VRAM 병목을 해결하기 위해 실시간 검색 증강과 가중치 압축 기술을 결합합니다.
- RAG(검색 증강 생성, Retrieval-Augmented Generation): 모델 가중치를 수정하지 않고 질문에 맞춰 외부 벡터 DB에서 관련 문서를 실시간 검색해 프롬프트에 주입함으로써 사실 출처를 보강하고 환각을 억제합니다.
- 양자화(Quantization): 16비트 부동소수점 가중치를 4비트 또는 8비트 정수형으로 압축하여 VRAM 점유율을 대폭 낮추고 일반 PC 환경에서도 경량 실행을 지원합니다.
- GGUF 포맷:
llama.cpp 기반의 범용 로컬 바이너리 모델 파일 포맷으로, CPU와 GPU의 자원을 분할 오프로딩하여 효율적으로 모델을 구동합니다.
- MLX 프레임워크: Apple Silicon 환경의 통합 메모리(Unified Memory) 대역폭을 온전히 활용해 고속 로컬 추론과 경량 파인튜닝을 지원하는 전용 머신러닝 라이브러리입니다.
Note: 실무 환경 구축 시 무조건 파라미터 크기만 늘리는 것보다, 목적에 부합하는 소형 모델(SLM)에 양자화와 RAG를 결합하는 것이 운영 비용과 지연 시간을 통제하는 가장 효율적인 아키텍처입니다.

댓글목록
등록된 댓글이 없습니다.