LLM(거대언어모델)의 주요 구성 요소 총정리: 텍스트 입력부터 응답 생성까지
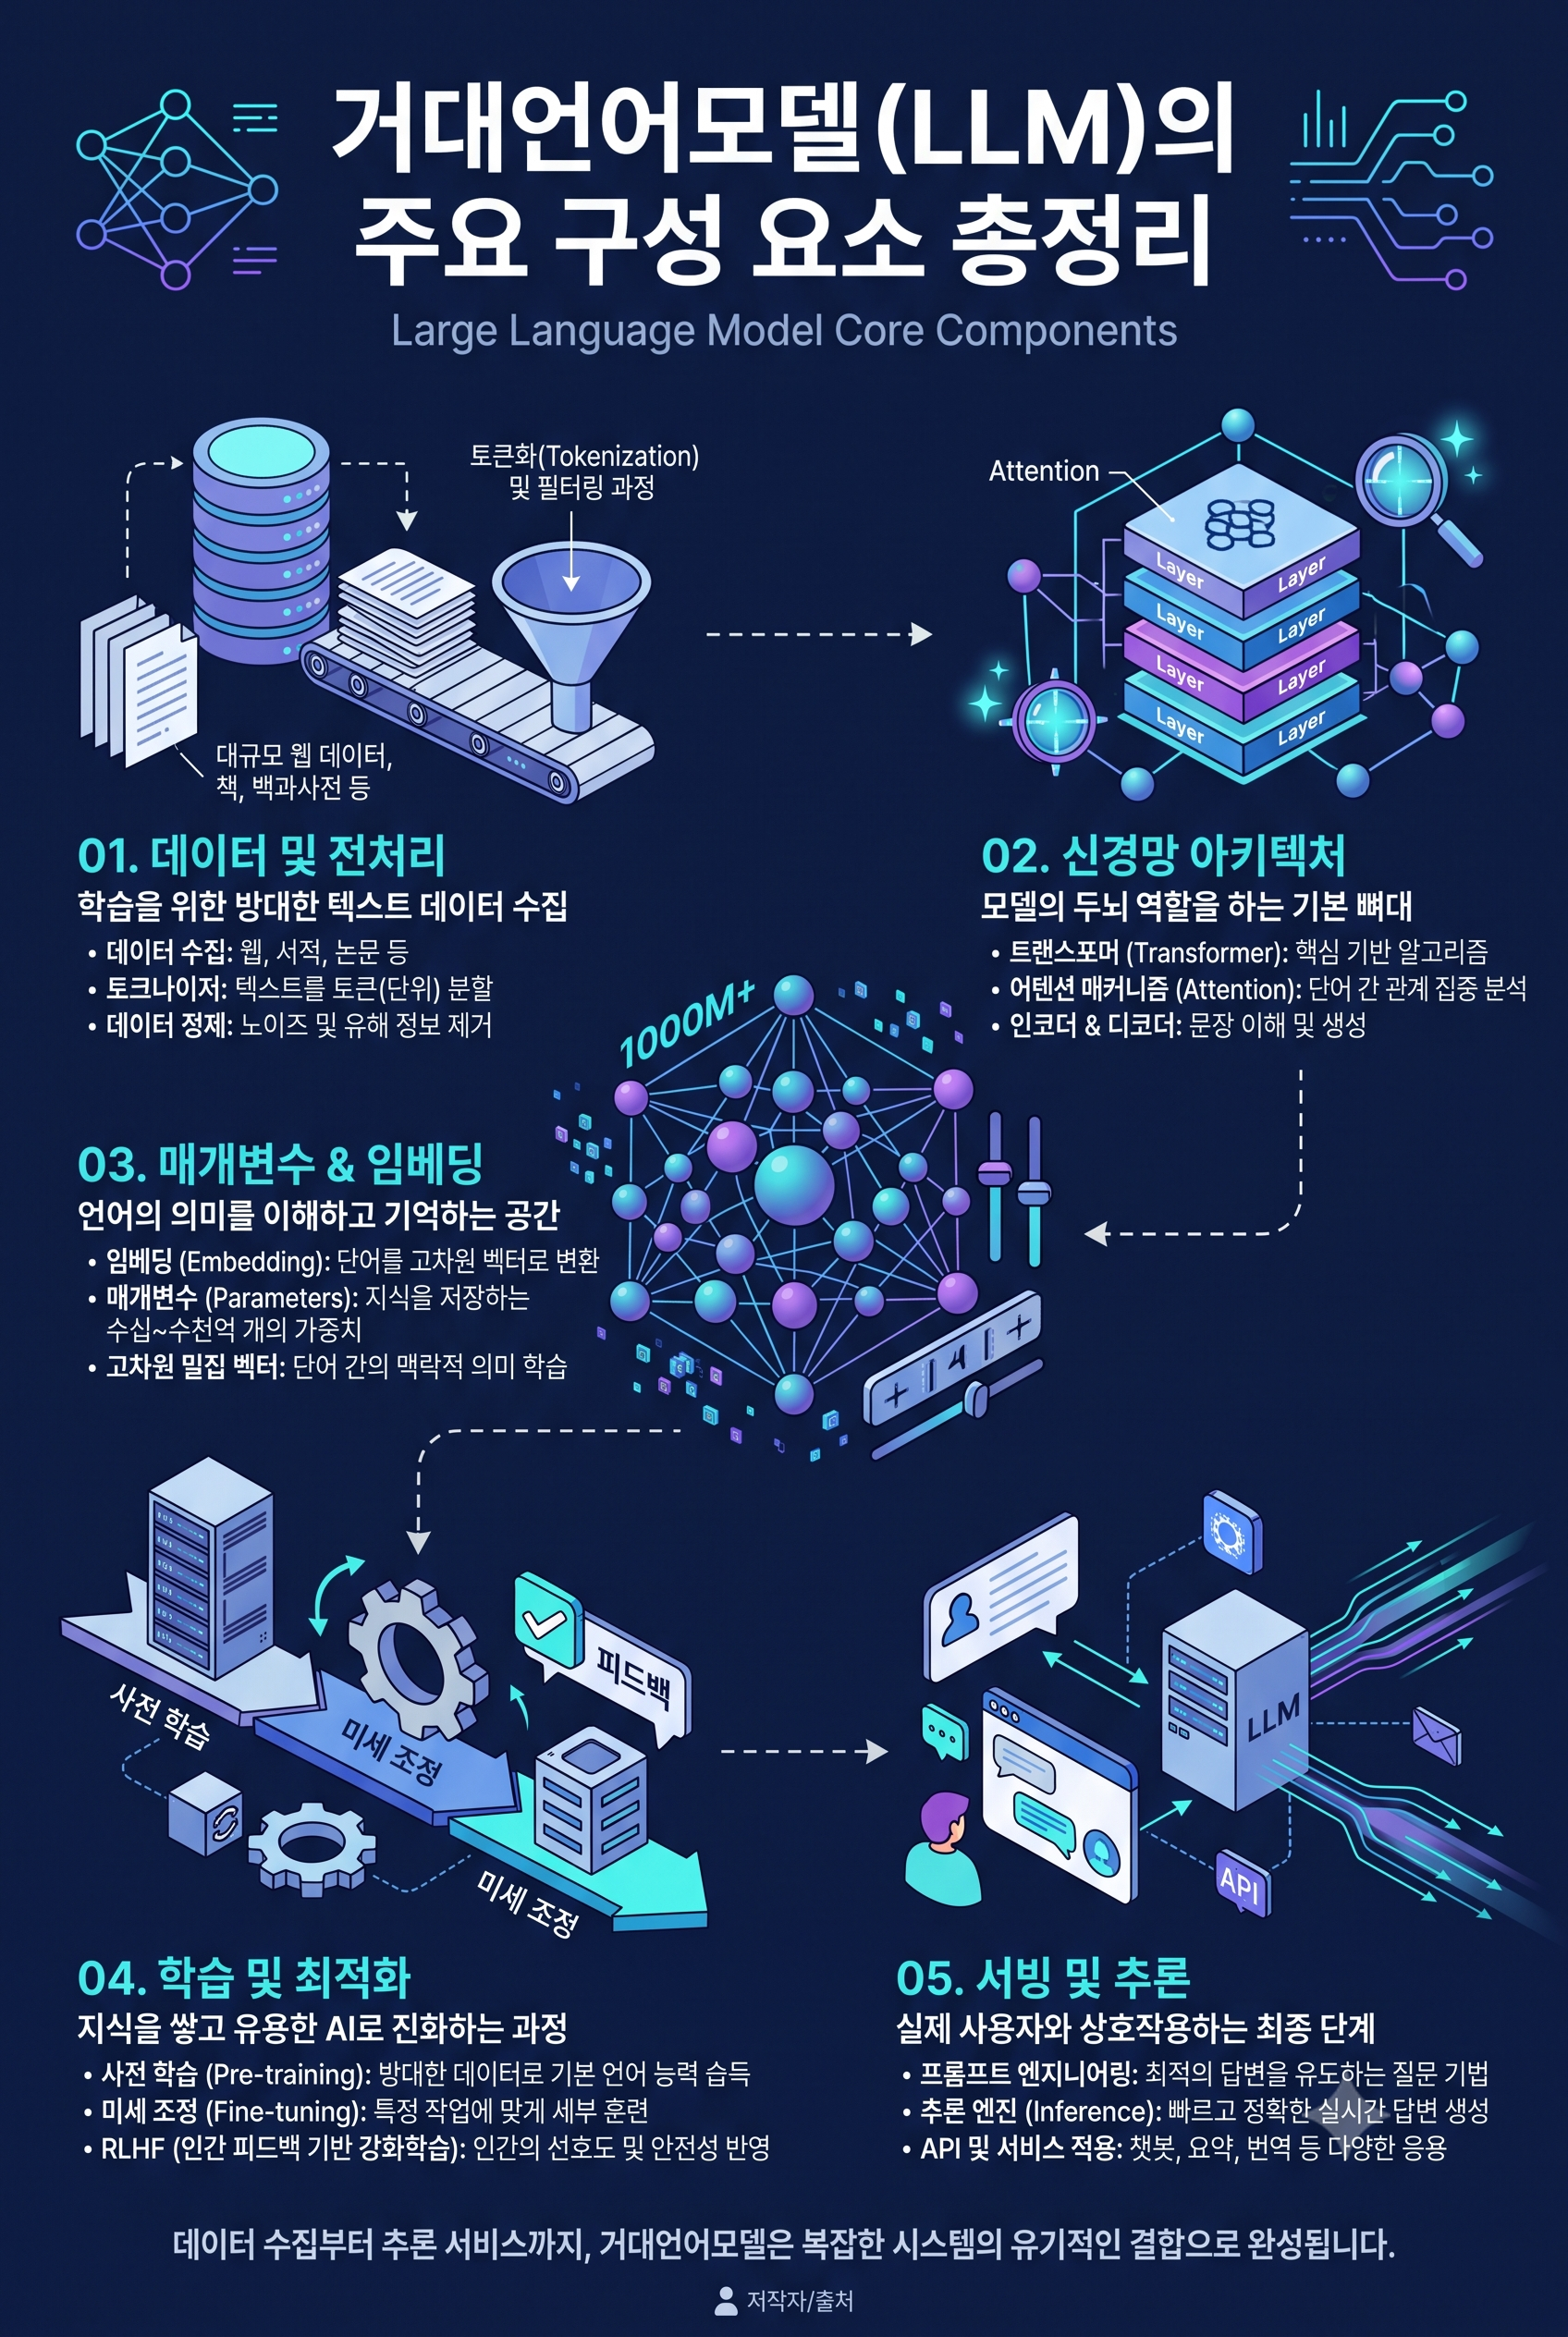
거대언어모델(LLM)은 단순히 문장을 통째로 암기해 출력하는 프로그램이 아니라, 여러 핵심 서브시스템과 아키텍처 모듈이 유기적으로 결합된 복합 인공지능 시스템입니다[cite: 1, 2, 3]. 자연어 텍스트를 수치 데이터로 분해하고, 문맥을 계산하며, 정렬을 거쳐 정교한 응답을 생성하기까지 LLM을 이루는 핵심 구성 요소를 단계별로 정리합니다[cite: 2, 3].
[Flowchart] LLM의 핵심 구성 요소 및 처리 파이프라인
[1. 토크나이저(Tokenizer)] ➔ [2. 임베딩 레이어 & 위치 인코딩] ➔ [3. 트랜스포머 백본 (Self-Attention & FFN)] ➔ [4. 언어 모델 헤드 (Softmax)] ➔ [5. 미세조정 및 정렬 모듈 (RLHF/SFT)]
원시 텍스트가 수치 연산을 거쳐 최종 토큰으로 출력되는 LLM 구조도[cite: 2, 3]

1. LLM 5대 핵심 구성 요소
1) 토크나이저 (Tokenizer)
토크나이저는 사용자가 입력한 자연어 문장을 모델이 처리할 수 있는 가장 작은 의미 단위인 토큰(Token)으로 쪼개고 정수 ID로 변환하는 입력 전처리 관문입니다[cite: 3].
- 동작 방식: 단어, 형태소, 서브워드(BPE, WordPiece 등) 단위로 텍스트를 분할합니다[cite: 3].
- 역할: 사전에 정의된 고유 어휘 사전(Vocabulary)과 대조하여 각 텍스트 조각을 고유 정수 번호에 매핑합니다[cite: 3].
2) 임베딩 레이어 및 위치 인코딩 (Embedding & Positional Encoding)
단순 정수 번호는 단어 간의 유사도나 순서 정보를 담지 못하므로, 이를 다차원 벡터 공간에 배치하는 단계입니다[cite: 3].
- 토큰 임베딩: 수백~수천 차원의 연속된 벡터 공간에서 의미가 유사한 단어들이 가까운 거리에 위치하도록 수치화합니다[cite: 3].
- 위치 인코딩 (Positional Encoding / RoPE): 트랜스포머는 입력을 한 번에 병렬 처리하므로 단어의 등장 순서를 알지 못합니다[cite: 1, 3]. 따라서 문맥상 위치 정보를 벡터에 결합하여 어순을 보존합니다[cite: 3].
3) 트랜스포머 백본 (Transformer Backbone)
LLM의 실질적인 두뇌 역할을 수행하는 핵심 딥러닝 아키텍처입니다[cite: 2, 3].
- 셀프 어텐션 (Self-Attention / Multi-Head Attention): 문장 내 모든 토큰 간의 상관관계와 가중치를 계산하여, 대명사 지칭 대상이나 다의어의 정확한 문맥적 의미를 파악합니다[cite: 1, 3].
- 피드포워드 신경망 (FFN, Feed-Forward Network): 어텐션 레이어가 포착한 문맥 정보를 비선형 변환하여 모델 내부의 사실적 지식(Parametric Memory)을 축적하고 처리합니다[cite: 2, 3].
- 레이어 정규화 및 잔차 연결 (Normalization & Residual Connection): 수십 개 이상의 깊은 레이어를 통과할 때 신호가 왜곡되거나 사라지는 현상을 방지해 안정적인 학습과 추론을 보장합니다.
4) 언어 모델 헤드 및 디코딩 (LM Head & Sampler)
트랜스포머 블록을 통과한 고차원 벡터를 최종 텍스트로 환원하는 출력단입니다[cite: 3].
- Softmax 레이어: 어휘 사전에 있는 수만~수십만 개의 후보 토큰들에 대해 다음에 올 확률 분포를 계산합니다[cite: 3].
- 디코딩 샘플러 (Temperature, Top-p/k): 확률 분포 중 어떤 방식으로 다음 단어를 선택할지 결정하여 창의성과 일관성의 균형을 맞춥니다[cite: 3].
5) 정렬 및 미세조정 모듈 (Alignment & Fine-tuning)
방대한 지식을 갖춘 사전학습 기초 모델(Foundation Model)을 인간의 의도에 맞게 제어하는 정렬 계층입니다[cite: 2].
- 지시어 튜닝 (SFT, Supervised Fine-Tuning): 질문-답변 형태의 대화형 데이터셋을 학습시켜 지시 이행 능력을 부여합니다[cite: 2].
- 인간 피드백 기반 강화학습 (RLHF / DPO): 유용성, 사실성, 안전성 기준에 맞게 모델의 응답 패턴을 인간의 선호도와 일치시킵니다[cite: 2].
2. 구성 요소별 기능 및 역할 비교
| 구성 요소 |
주요 기능 |
입력 형태 |
출력 형태 |
| 토크나이저 |
자연어 텍스트 분할 및 정수 인덱스 매핑[cite: 3] |
텍스트 문자열[cite: 3] |
정수 토큰 ID 시퀀스[cite: 3] |
| 임베딩 & 위치 인코딩 |
의미적 다차원 좌표 부여 및 어순 정보 합성[cite: 3] |
정수 토큰 ID[cite: 3] |
고차원 밀집 벡터 (Embedding Vectors)[cite: 3] |
| 셀프 어텐션 |
토큰 간 상관관계 계산 및 문맥(Context) 형성[cite: 1, 3] |
입력 토큰 벡터[cite: 3] |
문맥이 반영된 컨텍스트 벡터[cite: 3] |
| 피드포워드 신경망 |
비선형 정보 변환 및 장기 기억 지식 처리[cite: 2, 3] |
어텐션 출력 벡터 |
고도화된 특징 표현 벡터 |
| 언어 모델 헤드 |
사전 기반 다음 토큰 발생 확률 예측[cite: 3] |
최종 은닉 상태 벡터 |
토큰 확률 분포 및 다음 단어[cite: 3] |
| 정렬 레이어 |
안전성 확보 및 프롬프트 지시 이행 최적화[cite: 2] |
사용자 지시문 |
안전하고 유용한 정형 답변[cite: 2] |
3. 거대언어모델을 지탱하는 인프라 및 운영 요소
- 파라미터 가중치 (Weights & Biases): 모델의 지식과 추론 패턴이 저장되는 수십억~수천억 개 규모의 수치 파라미터입니다[cite: 1, 2].
- 컨텍스트 윈도우 (Context Window): 모델이 한 번의 추론에서 기억하고 참조할 수 있는 최대 토큰 한도입니다[cite: 2, 5].
- 최적화 및 배포 포맷 (GGUF, Quantization): 막대한 연산 자원을 절감하기 위해 가중치를 4비트·8비트 등으로 압축(양자화)하여 로컬 GPU/RAM에 적재할 수 있도록 돕는 런타임 기술입니다[cite: 1, 2].
결론
LLM은 텍스트를 숫자로 치환하는 토크나이저와 임베딩, 문맥과 지식을 연산하는 트랜스포머 백본, 그리고 최종 선택을 내리는 LM 헤드와 정렬 계층이 결합된 고도의 언어 처리 유기체입니다[cite: 2, 3]. 이 각 요소들이 유기적으로 맞물려 작동하기 때문에 단순한 단어 예측을 넘어 복합적인 문맥 이해와 논리적 추론이 가능해집니다[cite: 1, 2, 3].

댓글목록
등록된 댓글이 없습니다.