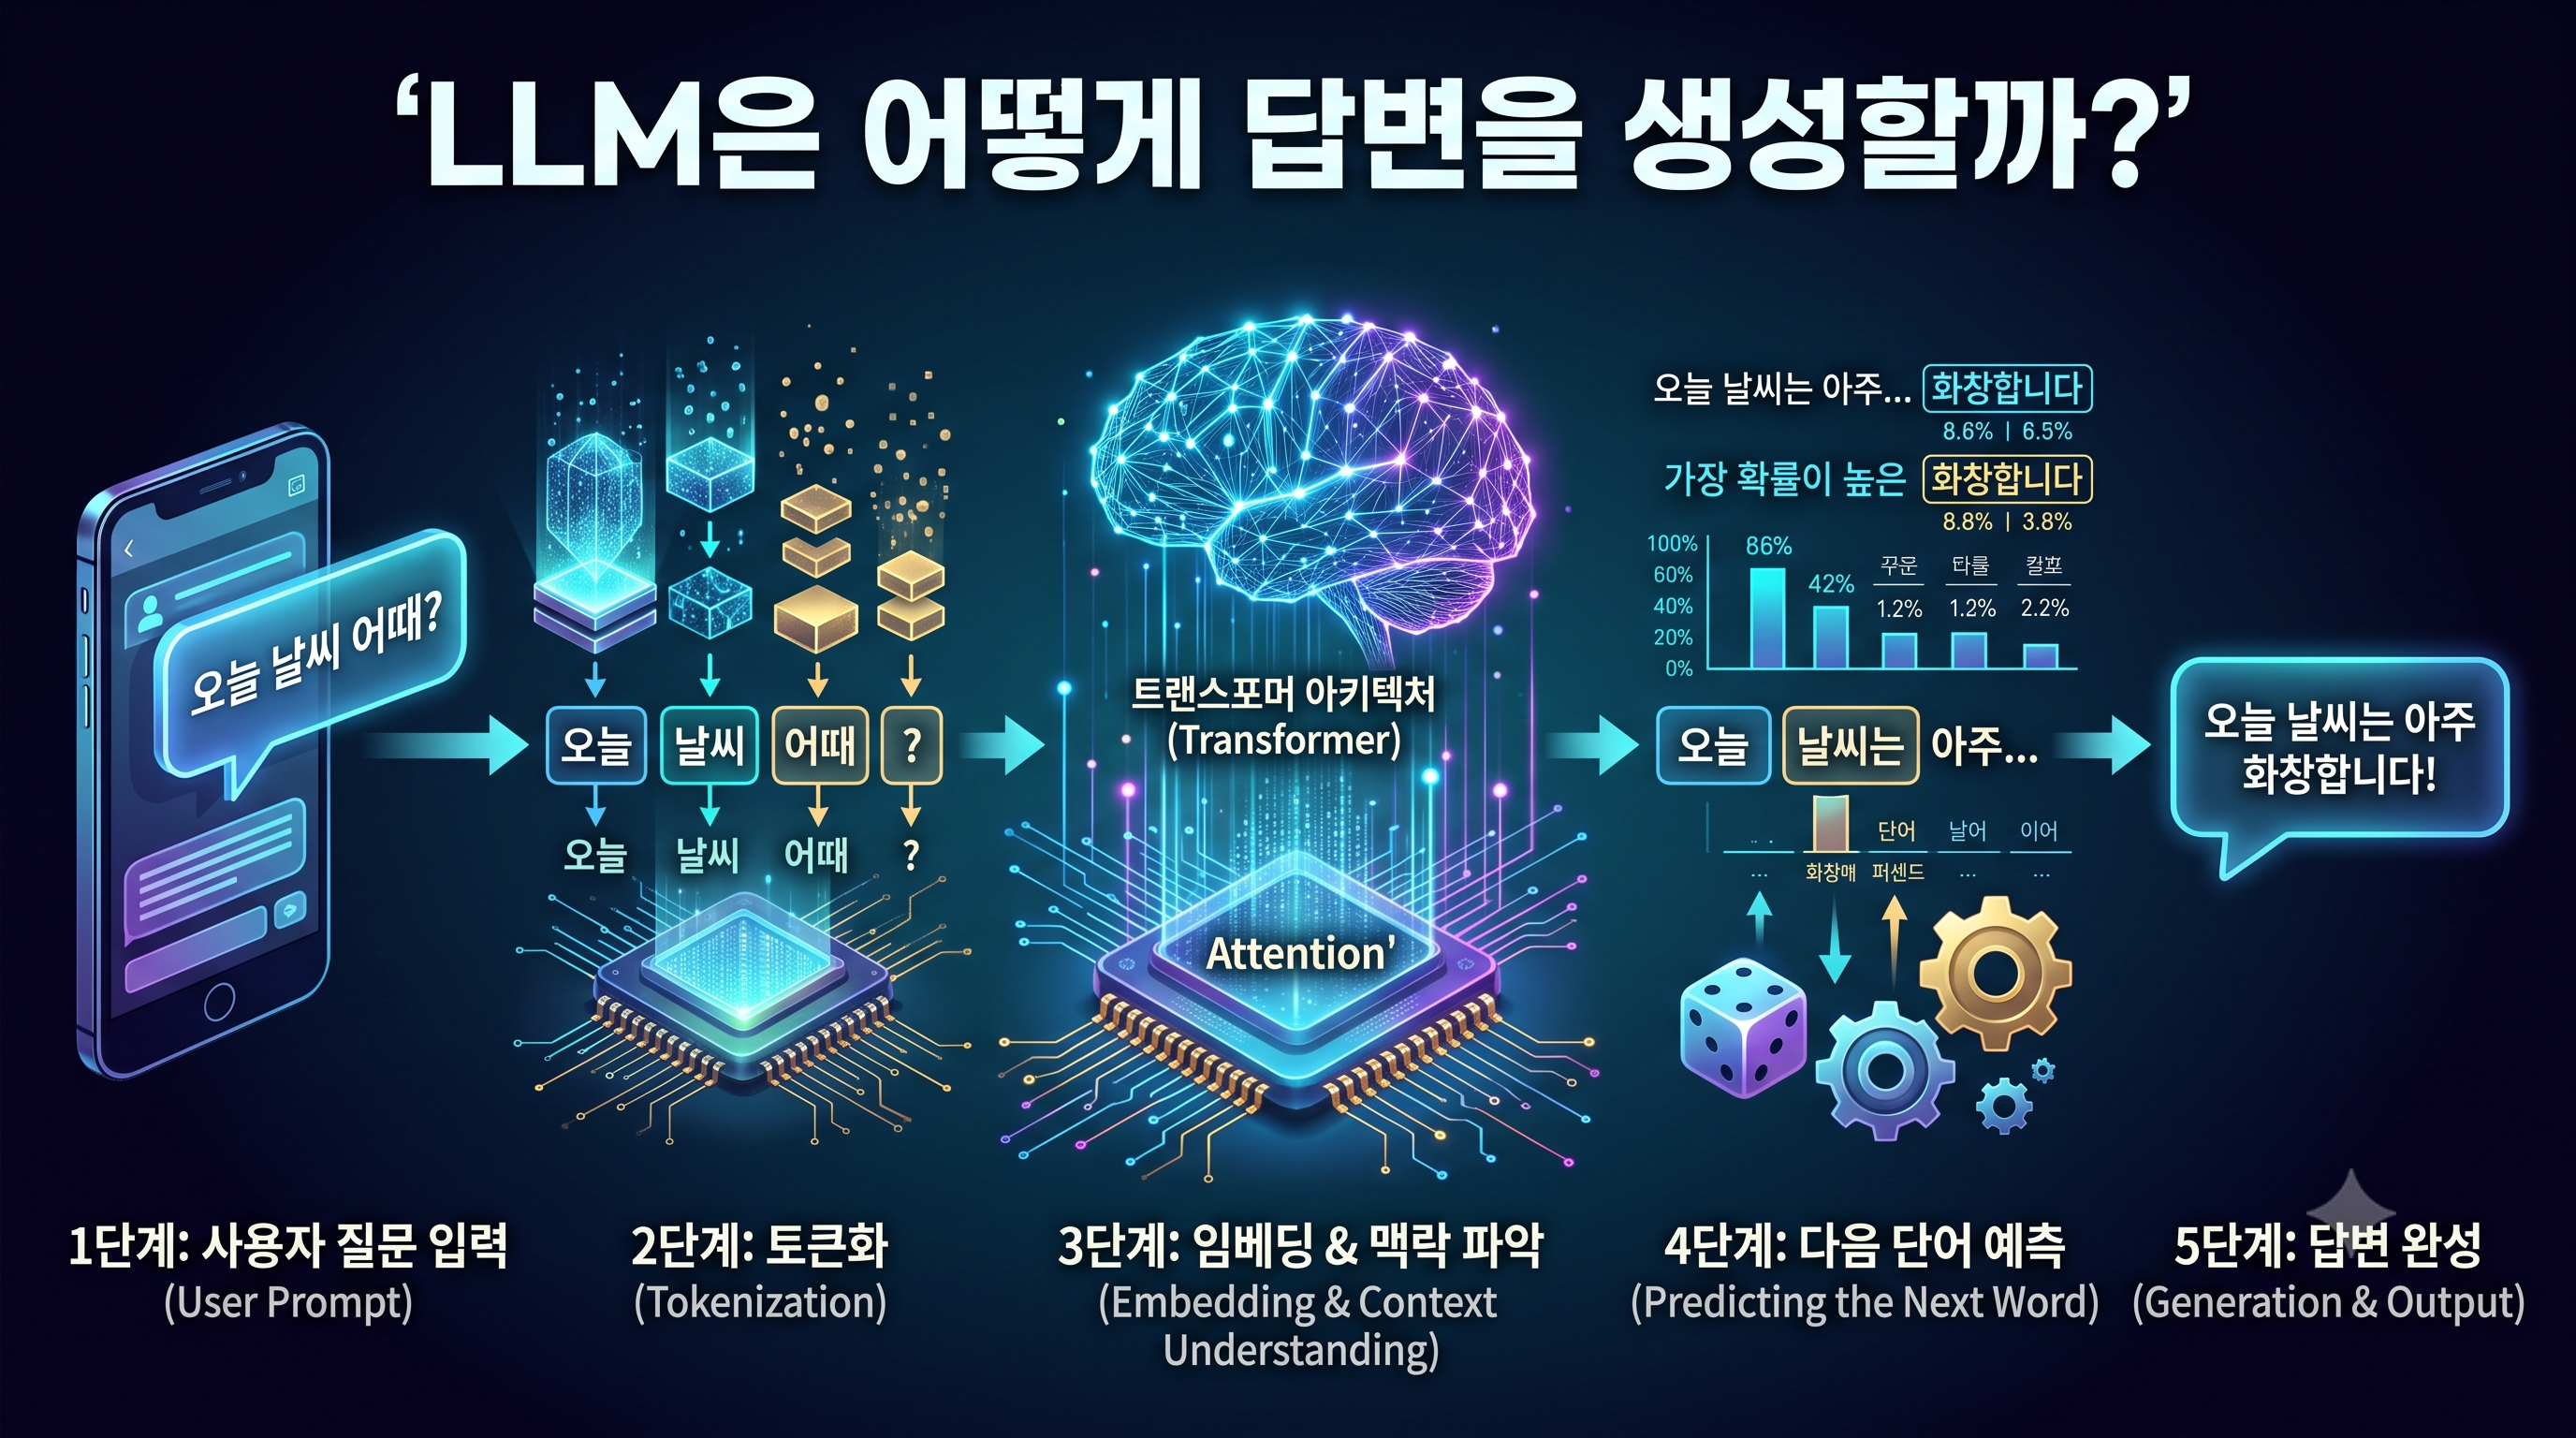
거대언어모델(LLM)은 사람이 미리 작성해 둔 정답을 데이터베이스에서 검색해 출력하는 것이 아니라, 문맥을 바탕으로 가장 자연스러운 다음 단어를 확률적으로 계산하여 실시간으로 문장을 만들어냅니다[cite: 1, 2, 4]. 프롬프트 입력부터 최종 응답 완성까지 이어지는 4단계 생성 메커니즘을 정리합니다[cite: 2, 5].
자연어 문장이 들어오면 모델이 연산할 수 있는 최소 단위인 토큰(Token)으로 쪼갠 뒤 고유 정수 번호로 바꿉니다[cite: 2, 5]. 이후 각 토큰을 다차원 벡터 공간에 좌표로 배치하고 어순 정보를 나타내는 위치 인코딩을 더해 단어의 의미적 거리와 배열 순서를 정의합니다[cite: 2, 5].
트랜스포머 아키텍처의 핵심인 셀프 어텐션 메커니즘은 문장 내 모든 단어 사이의 상관관계를 파악합니다[cite: 2, 5]. 다의어의 구체적인 뜻을 특정하거나 대명사가 가리키는 대상을 계산하여 전체 질문의 맥락을 수학적으로 압축합니다[cite: 2].
문맥 벡터가 형성되면 모델의 출력단(LM Head)은 학습된 수만~수십만 개의 어휘 사전 중에서 "현재 문맥 뒤에 올 확률이 가장 높은 다음 토큰"의 확률 분포를 계산합니다[cite: 2, 5].
선택된 토큰을 기존 문장 끝에 붙여 새로운 입력으로 삼은 뒤, 다시 그 뒤에 올 다음 토큰을 계산하는 과정을 반복합니다. 문장의 마침표나 종료 토큰(EOS, End of Sequence)이 나올 때까지 이 루프를 돌아 전체 답변을 완성합니다.
모델이 확률 분포 중에서 단어를 선택할 때, 항상 확률 1위인 단어만 고르면 답변이 지나치게 기계적이고 반복적으로 변합니다[cite: 5]. 이를 조정하기 위해 디코딩 샘플러를 활용합니다[cite: 5].
| 파라미터 | 역할 | 설정에 따른 변화 |
|---|---|---|
| Temperature | 확률 분포의 평탄화 정도 조절 | 낮추면 논리적이고 결정론적인 답변, 높이면 창의적이고 다양한 어휘 선택 |
| Top-p (Nucleus Sampling) | 누적 확률 상위 p% 내 후보만 선택 | 불필요하게 엉뚱한 단어를 배제하면서 문맥에 맞는 유연성 확보 |
| Top-k | 확률 상위 k개의 후보 단어만 제한 | 생성 후보군의 범위를 좁혀 엉뚱한 단어 출력을 방어 |
사전 학습(Pre-training) 단계의 모델은 단순히 웹 텍스트의 뒤를 잇는 예측기일 뿐이므로 사용자의 질문 의도를 만족하기 어렵습니다[cite: 1, 3, 4]. 유용하고 안전한 답변을 만들기 위해 정렬 기법을 적용합니다[cite: 1, 3, 5].
LLM의 답변 생성은 지식을 검색해 복사하는 작업이 아니라, 질문의 문맥을 벡터로 압축(Self-Attention)한 뒤 가장 적절한 다음 토큰을 하나씩 확률적으로 이어 붙이는 통계적 추론 과정입니다[cite: 1, 2, 5].

댓글목록
등록된 댓글이 없습니다.